
自动字幕在官方能力清单里,和另外三项并列。真正省时间的不是识别本身,是改错字的方式:在对话里说哪一句错了,它改文本,时间线不动。识别要靠模型,错字集中在专业词和人名;改字要靠对话,比在时间线上翻片段快得多。
CapCut官方给插件列的四项能力里,自动字幕是其中一项,另外三项是搜模板、剪视频、生成图和视频。这条写得很明确,不需要猜。
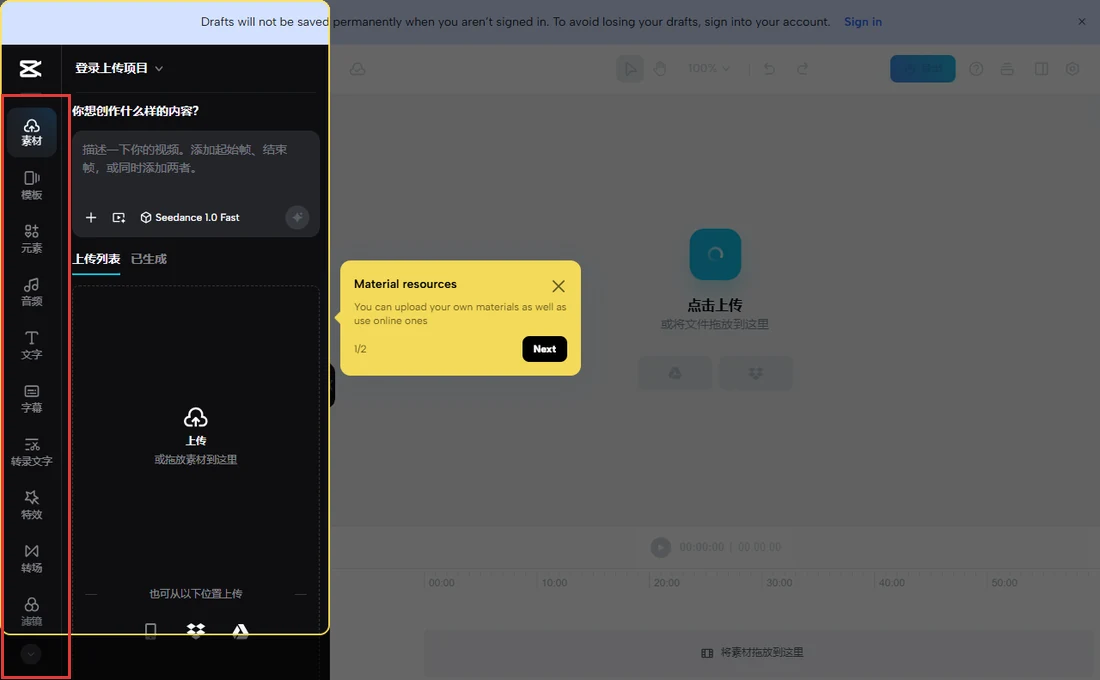
编辑器里对应的入口有两个:字幕和转录文字。字幕面板处理的是上屏文字,转录文字面板处理的是把语音转成文稿,两者分工不同,前者管显示,后者管内容。
这两个面板的存在说明一件事:字幕在这个体系里是独立图层,不是烧在画面上的。是不是独立图层,决定了后面能不能改、改起来有多贵。
这是新版和旧版最大的差别。旧版是生成一条字幕轨让你自己去时间线上拖,新版是在对话里说改哪一句,它改文本、对时长、重排位置,时间线本身不动。
这个差别在返工的时候最明显。旧方式改一个字,要找到那个片段、进编辑态、改完再对齐;新方式是把错的那句念出来,剩下的它处理。
不动时间线还有个隐含好处:画面和音频不受影响。改字幕不会触发重新编码,画质不会因为改字而掉一代。
自动字幕处理的是说话的转写,标题字幕处理的是画面上那几个大字。这两者不该合成一条轨,因为要求完全不同:前者要跟着语音走,后者要跟画面节奏走。
标题字幕放在文字层,用大字、粗体、短句。一句不超过九个字,竖屏下最多两行。它出现的时机通常是开头抓人、中间强调、结尾落版三处,不是全程都在。
合成一条轨的后果是改一个标题会牵动整段字幕的对齐。分开做,改标题只动文字层,自动字幕完全不受影响。
第一是专业词和人名。模型见过的通用词多,生造词和小众品牌名识别错是常态,这类错字只能人工校一遍,靠调参数解决不了。
第二是背景音。音乐压过人声的时候,识别会把歌词混进字幕里,出现一堆莫名其妙的句子。素材本身录音环境差的,先做人声增强再识别,准确率会明显不同。
第三是多人重叠说话。两个人抢话的部分,识别容易把两句并成一句。这种片段建议单独拎出来手动处理,别指望一次性过。
字号、字重、描边、位置、行数,这五项定下来就是一个样式。定好之后整片复用,不要一句一句调,那样永远调不齐。
竖屏下推荐的做法是白字加深色描边,字号定在中等偏大,位置压在离底边五分之一以上的地方。描边的作用是抗背景干扰,浅色画面里没描边的白字会看不见。
要手动熟悉字幕这一套流程,可以照即梦视频导入剪映做成片的步骤走一遍,里面讲到了字幕层的处理顺序;多工具一起用的,这套串联顺序也有对应的做法。
支持。这项能力在中文场景里是主力功能,识别中文语音没有问题,标点也会自动加。需要留意的是中英混说的片段,外语片段容易被按中文音译出来,遇到这类素材,单独把那几句摘出来手改,比整段重识别快。中英混说的片段,单独摘出来改更快,这类素材占比不高。
不会。字幕是独立图层,改文本只动这一层,画面和音频完全不受影响,也不会触发重新编码。这也是判断字幕做得好不好的标准之一:改一个字要重录画质的,说明字幕被烧进画面了,那种做法在改稿阶段代价很高。想确认有没有烧进去,双击字幕看能不能选中。
技术上能合成一条轨,实际不建议。两者跟着的节奏不一样:自动字幕跟语音,标题跟画面情绪,合在一起之后改一处动全身。分开两层,改标题只影响文字层,改对白只影响字幕层,各自独立,出错也容易回退。两层各自的位置和出现时机也不同,改的时候分别定位,别一起选。
先分清错在哪一类。专业词和人名的错,只能人工校,没有别的办法;背景音混进来的错,先做人声增强再重识别;多人抢话的错,把那几段单独切出来处理。三类混在一起改,会觉得怎么改都改不完,分开处理效率差好几倍。这一步分开做,能省下大半返工时间,顺序别乱。
1. CapCut 官方 CapCut×Codex 页面:https://www.capcut.com/zh-tw/tools/capcut-x-codex
我拿同一首歌试过立刻MV和剪映:立刻MV会围绕歌曲生成歌词字幕、分镜和视频,适合想快速做出完整MV的人;剪映更像通用剪辑工...
2026-10-11
我做短视频时一直用剪映,粗剪、字幕和配乐都很顺手,直到项目里用了几个带会员标记的特效,导出前才发现得升级。为了不让每...
2026-10-12
ChatGPT Plus Pro套餐分为两个主要档位:Pro 100(原5X)每月100美元,Pro 200(原20X)每月200美元。两档的核心区别在于Code...
2026-10-14
ChatGPT Dots怎么打开?在chatgpt.com/dots访问,点击”创建你的dot”按钮,依次设置名称、头像、应用授权和规则即...
2026-10-14
即梦负责出片段,剪映负责把片段接起来、加字幕配乐、按平台尺寸导出,两个工具分工清楚,成片才顺。即梦导出的是标准 mp4,...
2026-10-15