
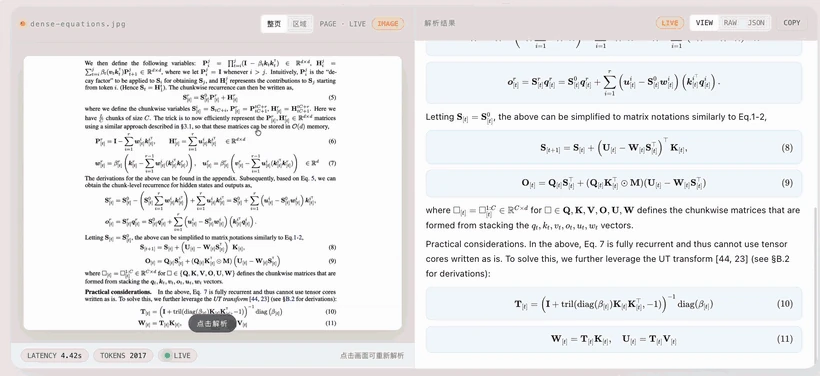
Xiaomi-OCR-0 是小米在 2026 年 9 月 30 日开源的0.8B 文档解析模型,一套权重同时干三件事:把整页文档读成结构化 Markdown、按指定字段抽 JSON、回答页面上数字之间的问题。表格它出 OTSL 再由后处理转成 HTML 塞进 Markdown,公式直接落成 LaTeX,都是能改的代码,不是截图里的死字。
常规 OCR 把字认出来排成一行行文本;它按自然阅读顺序还原版面,标题、正文、表格、公式各归其位,后两者还是可编辑代码。
时间线有个错位:论文 9 月 28 日提交,权重 9 月 30 日已放,小米 10 月 30 日才对外宣布。
三件活输出三种东西,靠同一套指令切换,不用为解析、抽取、问答各装一个模型。
同一份权重给了两种跑法,README 直接写了取舍,选错会掉精度。
区域依赖在纯 CPU 上也能跑,把 XIAOMI_OCR_LAYOUT_DEVICE 设成 cpu 即可,副作用是排版分析变慢。
三个解析榜的分数都用两阶段法跑出来:先版面模型,再逐块推理。
| 榜单 | Xiaomi-OCR-0 | 第一是谁 |
|---|---|---|
| Real5-OmniDocBench | 95.24 | 本模型 |
| OmniDocBench v1.6 | 96.83 | TeleOCR 96.87 |
| Wild-OmniDocBench | 87.94 | TeleOCR 88.53 |
表格没领先:PubTabNet 的 TEDS 是 92.27,TeleOCR 给到 97.05,差近 5 分。公式 UniMER-Test 97.84。古籍书法综合 73 分,闭源 Seed 2.0 Pro 是 72。
两条路:自己按文档装,或把一句话交给 Agent。后者会建环境、下权重、注册 MCP,动的是你本机,README 专门加了警告。
1.备齐 Python 3.10 以上,显卡按 SGLang 或 vLLM 支持的列表挑一张。
2.起推理服务,上下文长度按官方的 16384 设,架构名认 Qwen3_5ForConditionalGeneration。
3.跑 demo/server.py,端口 8787,整页、区域、抽取、问答共用同一个页面。
4.不想碰显卡就走 Ollama,社区 BF16 包约 1.8 GB,精度只做过有限验证。
PixPix怎么把多张图拼成对比图?PixPix本身不做拼版,拼图要在排版工具里完成:先用它统一出一组同角度、同背景、同尺寸的图...
2026-10-18
PixTV怎么给视频加片头片尾?片头片尾不在生成环节加,在成片合成或后期剪辑里拼;片头别超过正片时长的十分之一,超过观众就...
2026-10-18
PixTV怎么单独导出配音音频?平台不单独提供音轨下载,配音和画面是一起导出的;要音频只能从成片里提取,或者一开始就自己录...
2026-10-18
PixTV支持几个人同时用一个账号吗?能同时登录,但同时操作会互相顶掉:后登录的设备把先登录的挤下线,正在编辑的页面停在原...
2026-10-18
PixTV视频能变速吗?平台里没有变速开关,变速要在剪辑环节做;想让画面本身慢,得在生成时把动作描述写慢,靠后期拉长时间只...
2026-10-18