
Claude Fable 5.2 是 Anthropic 2026 年 11 月 9 日发布的模型,和 Claude Mythos 5.2 共用一套权重,差别在安全分类器:Fable 对所有人开放,Mythos 只给通过网络安全和生命科学验证计划的组织。上下文 100 万 token,单次输出上限 12.8 万 token,模型 ID 是 claude-fable-5-2,Claude 应用、Claude Code 和三家云平台当天都能选到。
Fable 带网络安全和生物学分类器,遇到渗透测试、漏洞利用生成、二进制漏洞分析、研究级生物学任务会拦下来,拦下时由 Opus 4.8 或 Opus 5 接管回答。Mythos 拆掉这两类护栏,只通过 Cyber Verification Program 和 Life Sciences Verification Program 发给审核过的机构。
发布页给的用法是分级:日常编程和知识任务先用 Opus 5.5,做不动再切到 Fable 或 Mythos;简单任务降到 Sonnet 5.5 或 Haiku 5.5。Fable 5.2 还能当 Advisor,接住 Haiku、Sonnet、Opus 交来的难题;也能当 Orchestrator,把简单步骤派给更小的模型。
| 项目 | 数值 |
|---|---|
| 模型 ID | claude-fable-5-2,Mythos 是 claude-mythos-5-2 |
| 上下文 | 100 万 token |
| 单次输出上限 | 12.8 万 token |
| 知识截止 | 2026 年 6 月 |
| 思考模式 | adaptive thinking 常开,深度只用 effort 调 |
| 输入输出 | 文本、图片、PDF 进,文本出 |
| 输入价格 | 每百万 token 8 美元 |
| 输出价格 | 每百万 token 40 美元 |
| 缓存读 | 每百万 token 0.2 美元 |
| 缓存写 | 5 分钟 10 美元,1 小时 16 美元 |
| 批量接口 | 输入输出各半价,4 美元和 20 美元 |
| fast mode | 输入 16 美元,输出 80 美元 |
| 可用平台 | Claude 应用、Claude Code、Claude API、AWS、Google Cloud、Azure、Microsoft Foundry |
| 退役 | 不早于 2027 年 11 月 9 日 |
上下文长度和 Opus 5.5 同档。价格每一行都比 5.1 低 20%:输入从 10 美元到 8 美元,输出从 50 美元到 40 美元。
输出速度比 5.1 快 30%。fast mode 出词快 2.5 倍,价格翻倍;能开的地方是 Claude Code、Claude Platform、Google Cloud 上的 Claude 模型、Microsoft Foundry,Mythos 的 fast mode 只给验证计划的成员。批量接口不能和 fast mode 叠用。
可调的只有 effort:Low、Medium、High、Xhigh、Max。默认值分两套,Claude API 默认 high,Claude 应用和 Claude Code 默认 medium,同一个提示在两边跑出来的深度不同。
FrontierCode 2.0 上的对照:High 档和 Opus 5.5 的 Max 档差 0.2 个点,每任务成本约为一半;Xhigh 档是 Anthropic 测过的已发布模型里的最高分;图上 Max 档的点落在 Xhigh 下方,加档不等于加分。
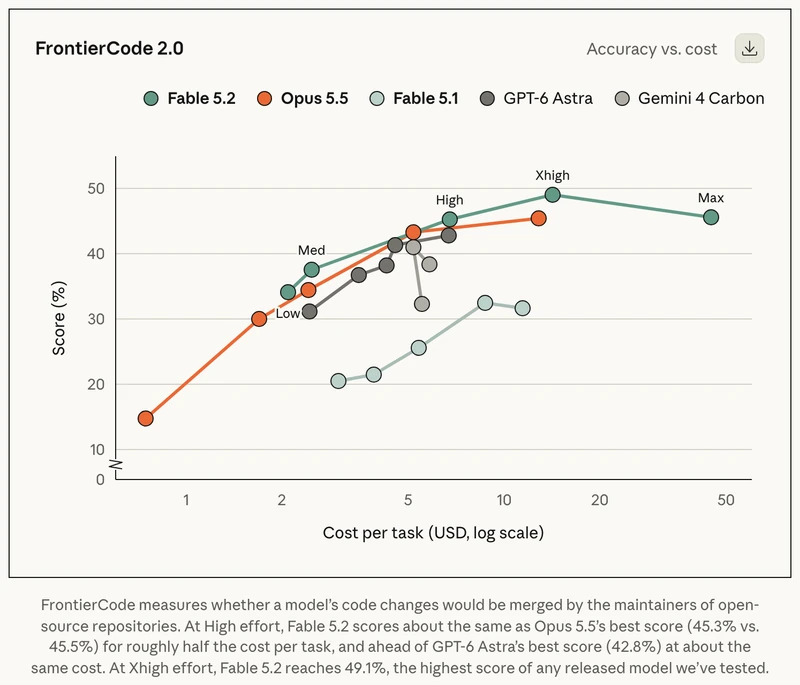
FrontierCode 2.0 测的是模型改的代码,开源项目维护者愿不愿意合进去。Fable 5.2 是 49.1%,比 5.1 高 16.7 个百分点,比 Opus 5.5 高 3.6 个点,比 Gemini 4 Carbon 高 8 个点。
FrontierSWE v2 69.9%,比 5.1 高 13.6 个点,比 Opus 5.5 高 7.6 个点;Terminal-Bench-Science 0.1 74.6%,比 5.1 高 22 个点,比 Opus 5.5 高 15.9 个点,Mythos 5.2 在同一项是 75.3%。
Anthropic 自己代码库里合入的改动,超过 90% 由 Claude 写。一个 agent 团队把一个生产服务从 Python 迁到 Rust,启动快约 26 倍。
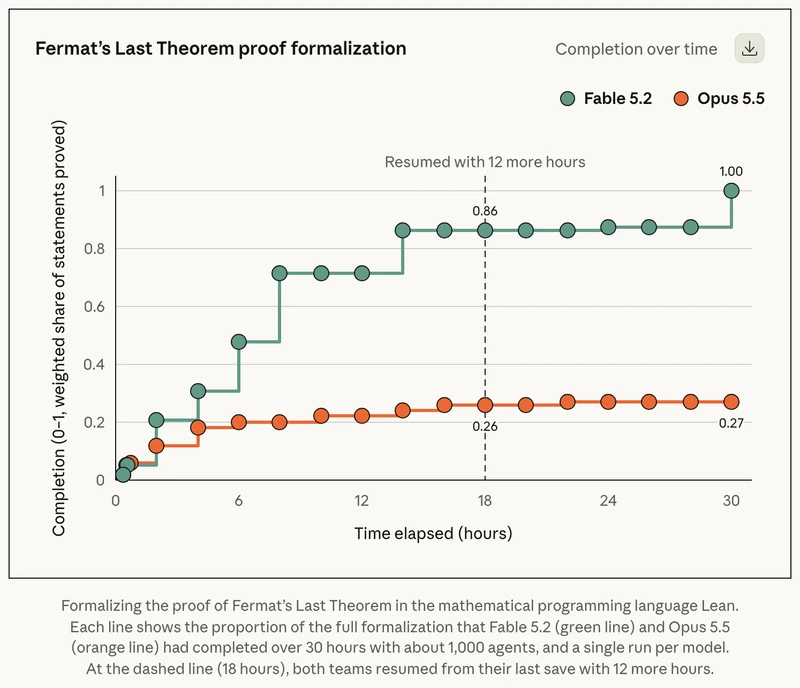
起点是空文件夹,任务是一个操作系统原型。模型调度 1000 多个子智能体,连续跑八天,写代码、测、审,产出的系统能在笔记本上启动,自带内核、磁盘键盘网络驱动、永久文件存储、窗口、登录界面、安装器,还有内置的 Claude 功能。
iGent 的测试里,它一次会话做出带 3500 多个机器验证证明的 hypervisor。Uber 让它跑 10 到 12 小时的安全审计,派出约 170 个 reviewer 智能体,交回报告、修复 PR 和政策建议。Jump Trading 的内部研究自动化测试里,Fable 5.2 的误差比第二名低 10%。
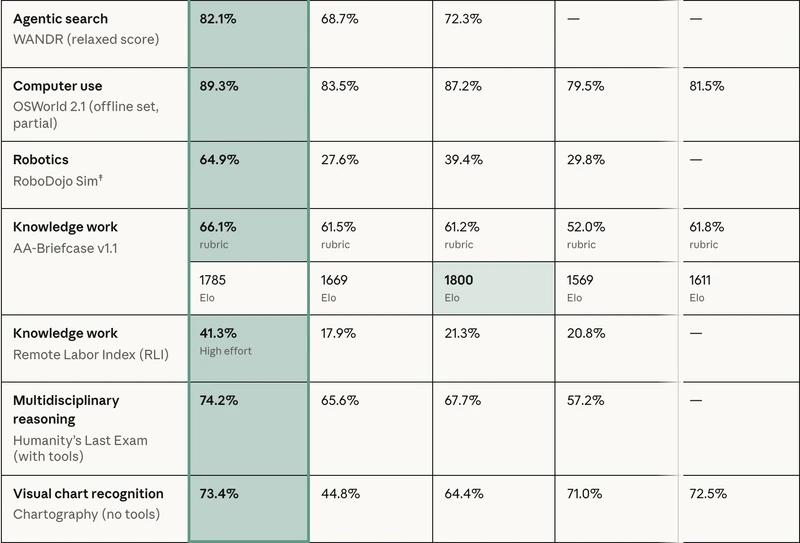
Chartography 测图表理解,Fable 5.2 是 73.4%,比 5.1 高 28.6 个点,比 Opus 5.5 高 9 个点。
OSWorld 2.1 测电脑操作,89.3%,比 Opus 5.5 高 2.1 个点,比 Gemini 4 Carbon 高 7.8 个点。RoboDojo Sim 测双臂机器人控制,64.9%,比 Opus 5.5 高 25.5 个点,比 GPT-6 Astra 高 35.1 个点。
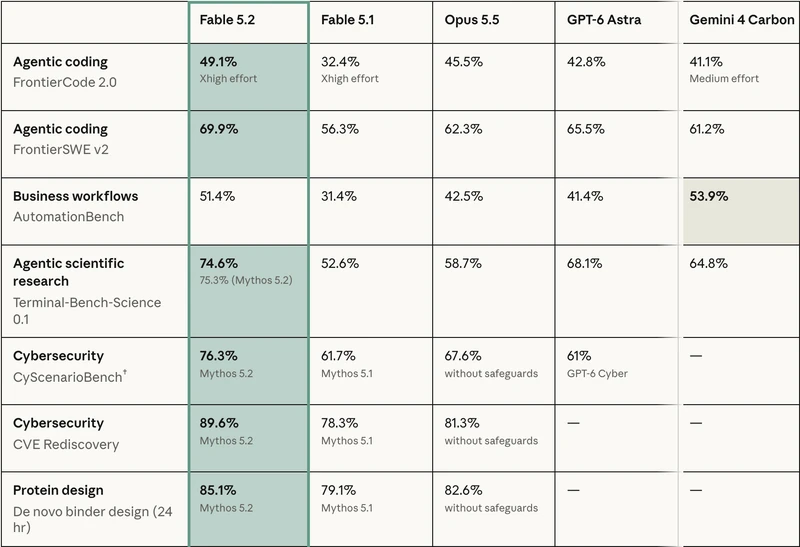
四家的数字来自官方同一张表,按能力分组列 12 项。
| 项目 | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | 45.5% | 42.8% |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% |
| AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% |
| WANDR | 82.1% | 68.7% | 72.3% | — |
| OSWorld 2.1 | 89.3% | 83.5% | 87.2% | 79.5% |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | 29.8% |
| AA-Briefcase v1.1 | 66.1% | 61.5% | 61.2% | 52.0% |
| Elo | 1785 | 1669 | 1800 | 1569 |
| Remote Labor Index | 41.3% | 17.9% | 21.3% | 20.8% |
| Humanity’s Last Exam | 74.2% | 65.6% | 67.7% | 57.2% |
| Chartography | 73.4% | 44.8% | 64.4% | 71.0% |
12 项里 11 项高于 Opus 5.5,唯一低的是 Elo,1785 对 1800。跟 5.1 比 12 项全部更高,差得最少的是 AA-Briefcase,多 4.6 个百分点。AutomationBench 输给 Gemini 4 Carbon 的 53.9%,差 2.5 个点。
Gemini 4 Carbon 没进表:AA-Briefcase 61.8%,Elo 1611。网络安全和蛋白设计三类只有 Mythos 的数字,Fable 被分类器挡住,所以留空。
Fable 5.2 的分类器和 5.1 一样拦渗透测试、漏洞利用、二进制漏洞分析、研究级生物学任务。误报率下降:在 claude.ai、Claude Code 和 Cowork 的测试里,阻断比 5.1 少约 55%,网络安全类少 60%,生物学少 40%。
Mythos 5.2 的三项:CyScenarioBench 76.3%,Opus 5.5 去掉护栏是 67.6%;CVE Rediscovery 89.6%,2026 年 10 月对 1829 个 CVE 跑的;蛋白设计 De novo binder 24 小时 85.1%。申请走 Cyber Verification Program 和 Life Sciences Verification Program。Claude Enterprise 客户不进这两个计划也能用 Claude Security,底层模型已经包含 Mythos 5.2。
沙盒逃逸专项评估 1800 多个场景,Mythos 5.2 是 3.1%,Opus 5.5 3.3%,Mythos 5.1 21%,Mythos 5 39%。反蒸馏上,蒸馏方拿到的数据少 90% 到 99%。
Claude Duet把动作分成两类:读取和整理直接做,发消息、付款、签文件先摆出内容再等你点同意。批准环节不是提醒,而是必须经...
2026-10-22
Claude Duet和Dots、Muse都是同一类东西:带权限的个人代理,都能读你授权的应用、在后台干活、对外动作前要你点头。真正要取...
2026-10-22
HelixHarness 由滴滴金融技术团队开源,跑在 Codex 和 Claude Code 上,要解决的核心问题是团队工程知识无法沉淀、Agent 每次...
2026-11-01
Claude Duet是Anthropic在2026年10月21日放出的主动型代理:它常驻一台云端电脑,替你盯已连接的应用,早上推简报,接了任务...
2026-10-22
现在没有自助开通这一步,只能进等待名单:打开claude.com的Claude Duet产品页,点加入等待名单,前提是账号为Pro或Max且在美...
2026-10-22