
VeriSpoof 是墨尔本大学在 2026 年 11 月 3 日提交到 arXiv 的音频大模型,做语音深度伪造检测。同一套权重回答四类取证问题,在 Speech-DF-Arena 的合并 EER 是 2.14%,开源权重里排第一。权重、代码、在线 Demo 和评测基准都放在 Hugging Face 与 GitHub 上,许可为 CC BY-NC 4.0,只允许非商业用途。
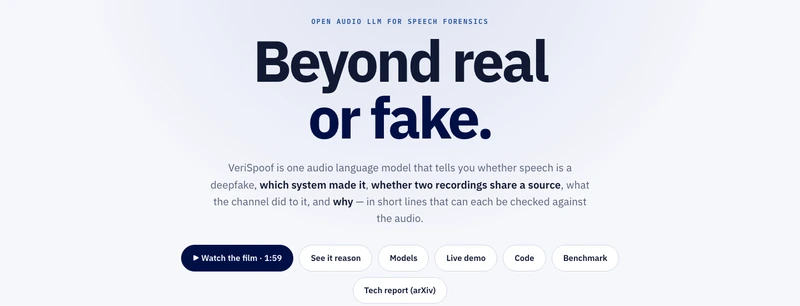
论文编号 arXiv 2611.04634,作者是 Yang Xiao 和 Ting Dang,两人都在墨尔本大学。它要解决的不是二分类:一条录音被当成证据提交时,做取证的人还要知道是哪个系统合成的、和另一段可疑录音是不是同一个来源、录制时经过了什么处理、依据是什么。
做法是把这几类问题都变成对同一句答案的打分。模型里没有任务专用的输出头,每个答案都是模型自己生成的一句话,再用这句话的概率当分数。
公开的东西可以按用途分开找:
界面上把五个问题排成一行标签,点开每个都能看到示例录音的选项和分数。
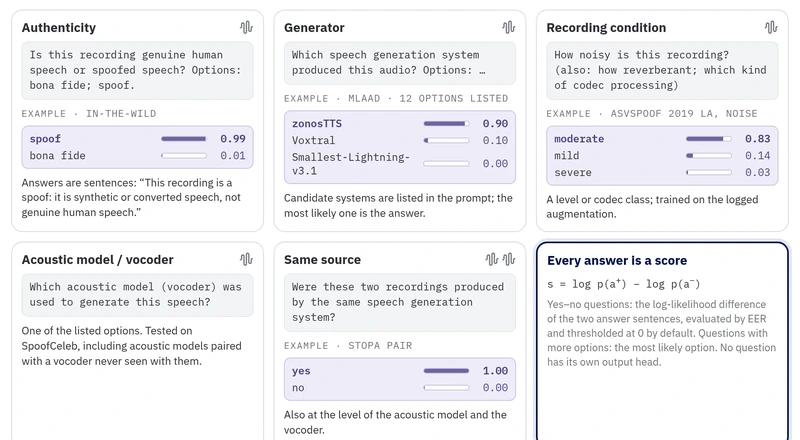
传统检测器在最后接一个二分类头,输出一个分数。VeriSpoof 把答案本身当输出,分数从这个答案句的概率算出来:
s = log p(spoof answer) − log p(bona fide answer)这样做的结果是不存在分数和解释对不上的环节。榜单上评的那个数,就是使用者读到的那句话的概率。
两段现成模型中间加一个从头训练的音频分词器,三段拼起来是 2.85B 参数,其中只有 29.7M 参与训练。
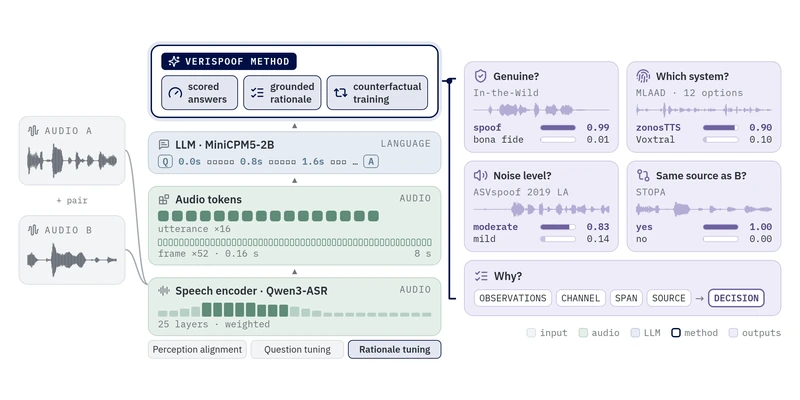
训练按三个阶段推进,每个阶段只训一部分部件:
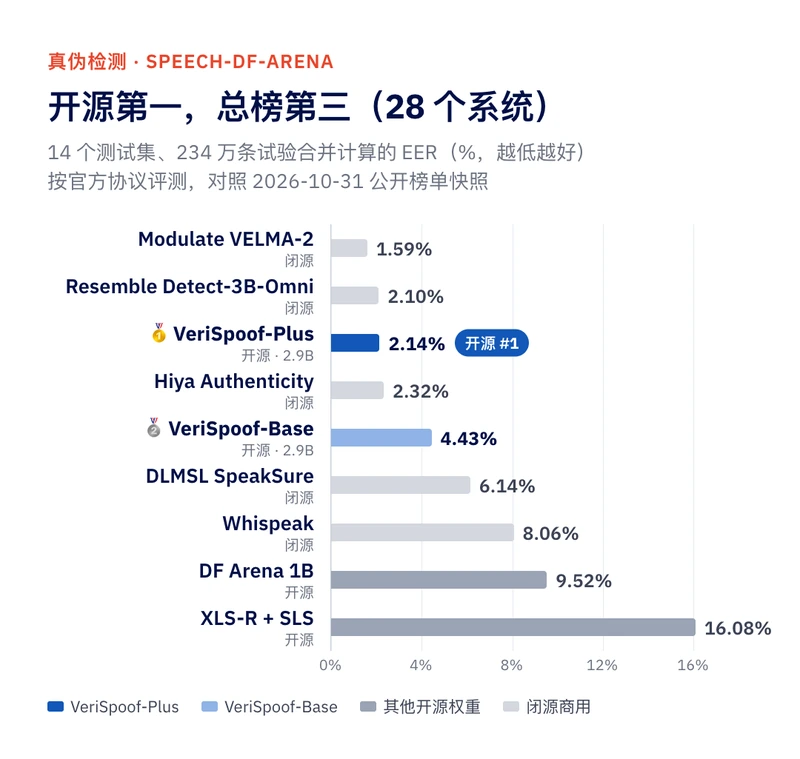
Speech-DF-Arena 官方协议共 14 个测试集、234 万条试验,用一个阈值统计全部试验得到合并 EER。VeriSpoof-Plus 是 2.14%,平均 EER 1.79%;VeriSpoof-Base 是 4.43%。
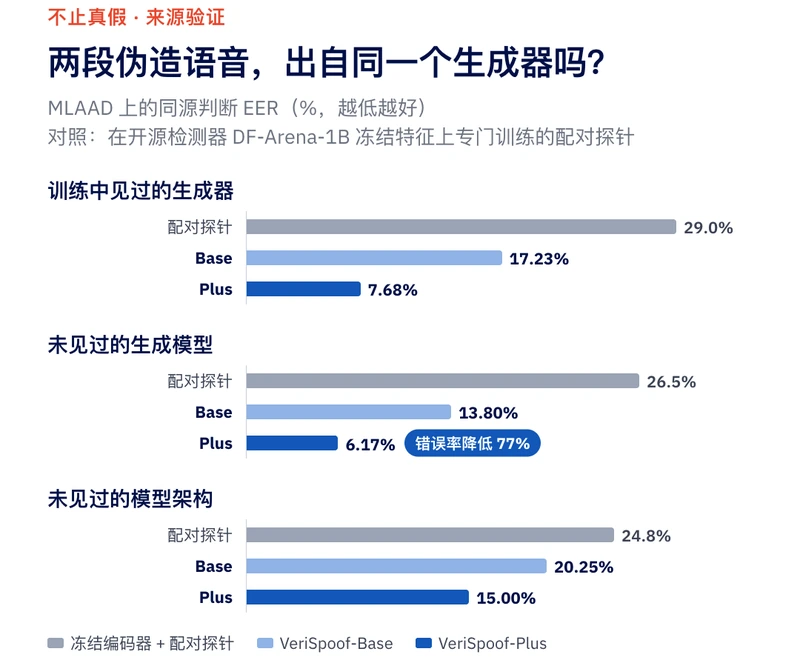
同源判断在 MLAAD 上按三种协议测:训练中见过的生成器、没见过的生成模型、没见过的模型架构。对照物是在开源检测器 DF-Arena-1B 的冻结特征上专门训练的配对探针,训练数据按同一套列表配齐。
| 测试协议 | 配对探针 | Base | Plus |
|---|---|---|---|
| 训练中见过 | 29.0% | 17.23% | 7.68% |
| 未见生成模型 | 26.5% | 13.80% | 6.17% |
| 未见模型架构 | 24.8% | 20.25% | 15.00% |
同一套权重还能直接点名生成系统,在 MLAAD 上准确率 96.8%;识别噪声、混响和编解码的准确率 81.3%。作为对照,六个通用音频大模型在同样的选择题上,同源判断落在 48.4% 到 53.3% 之间,二选一的随机水平是 50%,录音条件只有 16.4% 到 22.6%,随机水平是 12.5% 到 20%。这说明音频理解做得好的模型,不一定能分辨合成痕迹和信道特征。
推理按固定字段写,每一类陈述都有不依赖模型本身的检查器:
训练时加了反事实样本。把推理里的定位改成“没有合成片段”,结论要翻转;只改信道或观测行,结论必须保持不变。项目页写的是,99.5% 的决策能跟随训练中没见过的改法。
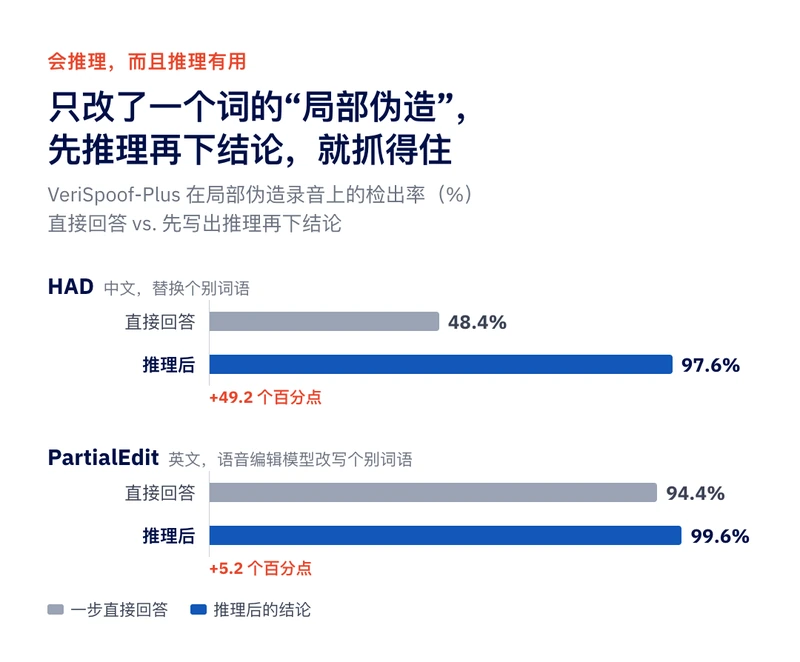
先写推理再下结论,能抓住一步回答漏掉的局部伪造。中文集 HAD 上,一步回答的检出率是 48.4%,推理后到 97.6%;英文 PartialEdit 上,Base 从 78.4% 到 99.6%,Plus 从 94.4% 到 99.6%。逐 token 定位头在 HAD、PartialEdit、PartialSpoof 上的 F1 分别是 0.91、0.79、0.77。
需要一张 12 GB 显存以上的 CUDA 显卡,权重第一次运行时下载。
hf download AustinXiao/VeriSpoof-Plus --include "code/*" --local-dir verispoofpip install ./verispoof/codemodel.detect("sample.wav")model.explain("sample.wav")model.same_source("a.wav", "b.wav", level="generator")model.condition("sample.wav", attr="codec")、model.generator("sample.wav", ["XTTS-v2", "Bark", "VITS"])hf download AustinXiao/VeriSpoof-Plus --include "code/*" --local-dir verispoof
pip install ./verispoof/codefrom verispoof import VeriSpoof
model = VeriSpoof.from_pretrained("AustinXiao/VeriSpoof-Plus")
model.detect("sample.wav") # 标签 + 分数
r = model.explain("sample.wav") # 推理文本、结论、片段、逐 token 概率
print(r["decision"], r["spans"], r["token_prob"])
model.same_source("a.wav", "b.wav", level="generator") # 也可 acoustic_model / vocoder
model.condition("sample.wav", attr="codec") # 也可 noise / reverb要批量跑可以换 vLLM 后端,官方给的说法是批量时约 46 倍加速。安装时带上 [vllm] 扩展,调用改成 VeriSpoofVLLM.from_pretrained,explain 和 compare 都能一次传多个文件或配对。
| 版本 | 训练数据 | 合并 EER | 适合的用法 |
|---|---|---|---|
| Base | 11 个语料,约 38 万条 | 4.43% | 受控对照实验 |
| Plus | 23 个语料,约 440 万条 | 2.14% | 直接使用 |
Base 只用公开语料的官方训练集,训练步数 8k、20k、10k,全局 batch 32,单张 48 GB 显卡约 14 GPU 小时。技术报告里的对照研究都基于 Base,复现别人的结论要从它开始。Plus 在同一套配方上多加 12 个语料,伪造部分按 211 个来源均衡采样、归并成 82 个架构族,真人部分按 18 个数据集均衡,避免大语料占多数。
两个版本的推理开销一样,任意采样率的录音直接输入,用 vLLM 批量 64 时一条 A100 上每条约 0.05 秒。
权重、代码、Demo、基准都已经是公开状态,装上就能跑,不用申请。
语音合成和语音克隆的门槛降到几秒样本之后,一个真假分数已经不够用。VeriSpoof 给出的方向是把取证拆成可以逐条核对的陈述,分数、来源、位置分开写,哪一条站不住一眼能看出来。
蛙蛙写作能写群像多主角吗?能,但要先把视角数量锁住,三到五个是能撑住的区间;群像崩掉的原因是人多而线不清,每人一条欲...
2026-10-18
蛙蛙写作注册需要实名吗?注册这一步不用上传身份证,手机号收码、设密码、填昵称就能进创作页;身份信息只在签约和提现时才...
2026-10-18
蛙蛙写作会员到期后还能改稿吗?能改,改的是你自己敲进去的文字,编辑器不会锁;不能用的是会员专属按钮,续写、扩写、换模...
2026-10-18
蛙蛙写作怎么申请发票?入口在账号的消费记录里,按订单开票,不是按整月总额开;要准备的是抬头、税号、接收邮箱三样。开票...
2026-10-18
蛙蛙写作敏感内容会被拦吗?会,而且拦在三个不同位置:输入框、生成过程、投稿提交,三处提示不一样。看懂提示在哪一层,才...
2026-10-18