
Hy Realtime 是腾讯混元 2026 年 11 月 13 日发布的实时语音模型,已在元宝语音通话和腾讯客服上线,腾讯云 API 的官方口径是近期开放,接口、配额和价格都没给。在元宝里试的路径是更新到最新版 App,点首页右上角电话图标进语音通话,选“自由对话”场景,把音色切成“初语”。没装 App 可以打开 rtcube.cloud.tencent.com 上的网页 Demo,单次最长 10 分钟,要手机号登录;模型在语音理解与表达之外新增了工具调用与唱歌。
发布渠道是腾讯混元公众号,2026 年 11 月 13 日 16:32 发文,没有开线下发布会。官方给的品类是实时语音模型,场景是通话,不是在文字框里一问一答。
官方把改动范围写成对语音实时交互模型做了重构,落到四处:算法框架、数据质量、评测方案、训推 Infra。
已上线的入口是元宝语音通话与腾讯客服等产品,元宝是 C 端入口,腾讯客服是业务场景,跑的是同一个模型。
官方在图注里标的是移动端免费体验,操作在元宝 App 内完成。
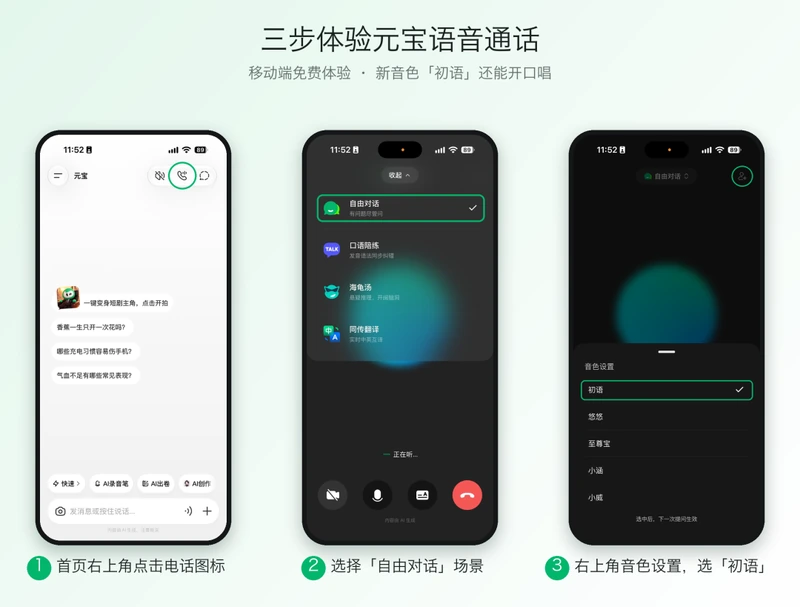
音色选中后不当场生效,下一次提问才用上“初语”。元宝 App 的下载地址是 yuanbao.tencent.com/download。
地址是 rtcube.cloud.tencent.com/component/hunyuan/index.html,页面标题写的是“混元语音对话 – 腾讯云 TRTC”。首屏文案写的是:点击按钮开口聊天,随时可以打断;单次体验最长 10 分钟。页面底部标的是“内容由 AI 生成 · 基于腾讯云实时音视频 TRTC & Hy Realtime”,Demo 走的是 TRTC 的实时音视频链路。
顶部两个标签:Hy Realtime、联网。联网在产品页上是固定标签,不在设置面板里单独开。左侧“助手设置”四项,说明文字写在面板里:
| 设置项 | 页面说明 |
|---|---|
| 联网搜索 | 开启后助手可以查实时信息,回答会慢一些 |
| AI 降噪 | 过滤环境噪声和远处人声,减少助手被误打断 |
| 麦克风来源 | 选择输入设备 |
| 助手音量 | 默认 100% |
点“开始对话”要先用 +86 手机号收验证码登录,勾选隐私协议和用户协议,不登录进不到对话界面。官方写明网页 Demo 只提供部分能力,元宝语音通话里的功能它不全有。
判断权在模型:它按对话上下文和用户意图决定要不要联网,不需要用户先说要搜。一次回答里串三步:搜索决策、调用工具、生成回答。
判错有两种:该搜没搜,用训练时的旧知识作答;不该搜却搜了,多一次往返,回答也会变慢。
RL 阶段对冗余检索做了阶梯式降权,奖励项里有一项叫搜索成本奖励。发布稿点名的工具只有联网搜索,没有列全部工具,也没有给判断准确率。
唱歌能力与腾讯音乐 TME 灵音 AI 团队 Co-Design,不是单独接一个歌声合成模型。点歌条件可以组合:歌手、专辑、曲风、语种、发行年份、热度六个维度。官方给的例子是“来首 2010 年到 2020 年之间的英文民谣”,模型接多轮上下文取条件、匹配歌曲、开口唱。
能承接前文继续选歌,点歌可以连续多轮。演唱上的改动列了三处:情绪层次、咬字与气息衔接、旋律与节奏。曲库规模和版权范围发布稿没写,点歌的匹配准确率也没给。
四个阶段串成一条链:模态对齐、任务联合、教师蒸馏、混合强化。
| 阶段 | 名称与训练过程 |
|---|---|
| Stage 1 | CT:Hy LLM Base 与 Audio Encoder 两路输入,过 Adapter 对齐、模态交织建模、复杂声学场景感知 |
| Stage 2 | SFT:基础智商任务、专项语音任务、工具调用任务三类联合 SFT,产出 SFT Model |
| Stage 3 | MOPD:基础能力教师与语音能力教师两路,Reverse KL 逐 token 监督,学生按 Rollout 更新 |
| Stage 4 | Mix-RL:混合 Rollout 分三组奖励,General RL、Agentic Search RL 与门控奖励,最后更新策略、同步权重 |
Stage 1 产出 CT Model,Stage 4 结束产出 Hy Realtime。
CT 数据到千万小时级,任务形态从 ASR 扩到音频理解、音乐理解、语音翻译,配 51 套纯文本集与 50+ 套语音评测集。
SFT 侧的专项数据点名的是 Context-ASR、长程多轮、指令遵循、逻辑推理、需求理解、情感共情、工具调用;清洗用 MinHash LSH 去重、Topic 均衡分布、人工抽检,外面套十维刚性评测护栏。预训练阶段的感知目标不止语音转文本,还包括情感、语调与环境音。
官方原句是:将高质量文本数据向语音任务的有效迁移保留率从 21% 提升至 69%。说的是文本模型里的知识与推理转成语音问答后还能剩下多少,差额来自端到端语音模型的跨模态智商折损。
口径没公开:测试集、判定方式、样本量发布稿都没写,只能按官方自述看。
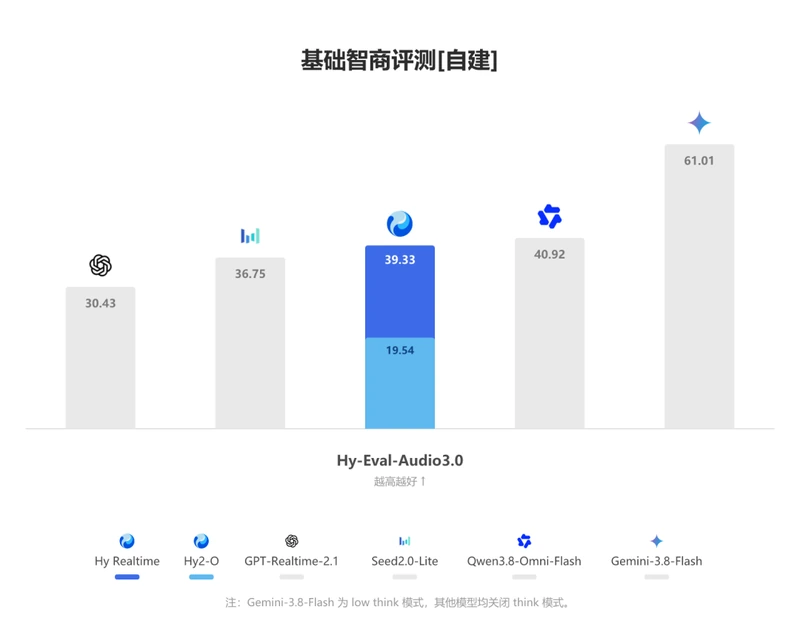
自建的基础智商评测叫 Hy-Eval-Audio3.0,覆盖数学、科学、逻辑推理、知识问答、复杂指令、文本理解、多轮;Hy Realtime 得 39.33,上一代 Hy2-O 是 19.54。
做法是把文本与语音放进同一条序列协同建模,边生成文本边合成语音,不等整段文本说完再开口。训练按顺序分三段:
顺序是先通用后专用,前两段管能说与会说,第三段管音色与情感。发布稿没有给首响延迟的毫秒数。
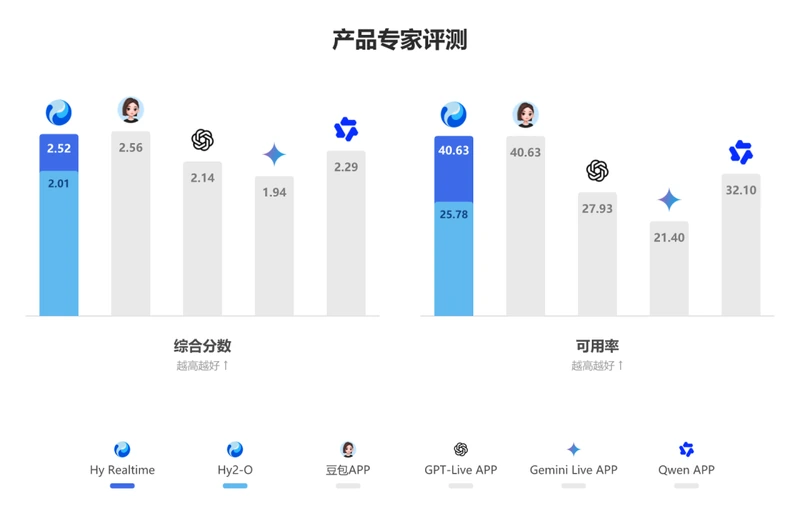
专家盲评的对标对象是产品不是接口,六个名字各自对应用户能装到的 App,下表按综合分数从高到低排:
| 模型 | 综合分数 | 可用率 |
|---|---|---|
| 豆包 APP | 2.56 | 40.63 |
| Hy Realtime | 2.52 | 40.63 |
| Qwen APP | 2.29 | 32.10 |
| GPT-Live APP | 2.14 | 27.93 |
| Gemini Live App | 1.94 | 21.40 |
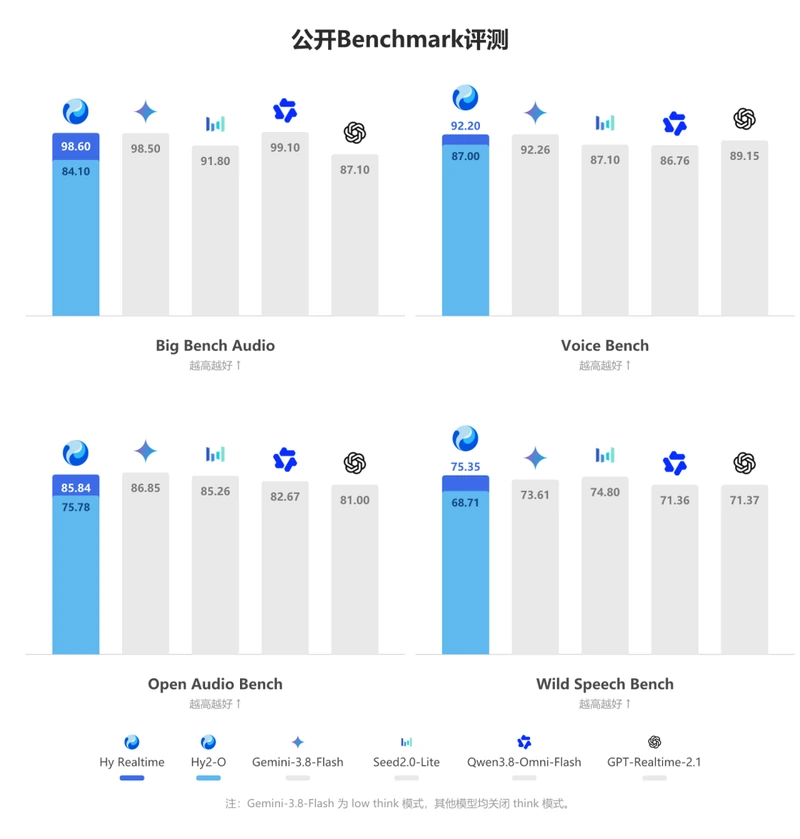
可用率一项 Hy Realtime 与豆包 APP 都是 40.63,并列第一,综合分数豆包 APP 高 0.04。四个公开榜里只有一个第一:Wild Speech Bench 75.35,第二名 Seed2.0-Lite 74.80;另外三项都排第二,与第一名的分差是 Big Bench Audio 0.50、Voice Bench 0.06、Open Audio Bench 1.01。
| 模型 | Big Bench Audio | Voice Bench | Open Audio Bench | Wild Speech Bench |
|---|---|---|---|---|
| Hy Realtime | 98.60 | 92.20 | 85.84 | 75.35 |
| Qwen3.8-Omni-Flash | 99.10 | 86.76 | 82.67 | 71.36 |
| Gemini-3.8-Flash | 98.50 | 92.26 | 86.85 | 73.61 |
| Seed2.0-Lite | 91.80 | 87.10 | 85.26 | 74.80 |
| GPT-Realtime-2.1 | 87.10 | 89.15 | 81.00 | 71.37 |
图注写明 Gemini-3.8-Flash 用的是 low think 模式,其他模型都关掉 think。
下一步列在发布稿结尾,三条:
都写在“下一步”,不是这一版已经交付的能力。
混元视频大模型(HunyuanVideo)是腾讯推出的视频生成大模型,原版参数超过130亿,支持文本生成视频和图像生成视频。混元视频...
2026-10-14
元宝桌宠是腾讯元宝PC端v2.87.10及以上版本自带的桌面宠物功能,集智能助手与陪伴体验于一身。要在PC端开启元宝桌宠,需要先...
2026-10-17
腾讯元宝是腾讯推出的AI对话助手,支持手机APP、电脑版和网页使用。会议纪要可以把录音转文字、现场记录或长文稿直接发给元宝...
2026-10-17
腾讯元宝是腾讯推出的AI对话助手,能聊天问答、写文案、总结资料、翻译。电脑版能用,有客户端也能直接用浏览器打开网页版。...
2026-10-17
点淘元宝靠签到、任务和看播攒,攒了在兑换页换。元宝是激励玩法的记账单位,来源每一笔都进元宝明细。攒到兑换页的档位就换...
2026-10-22