
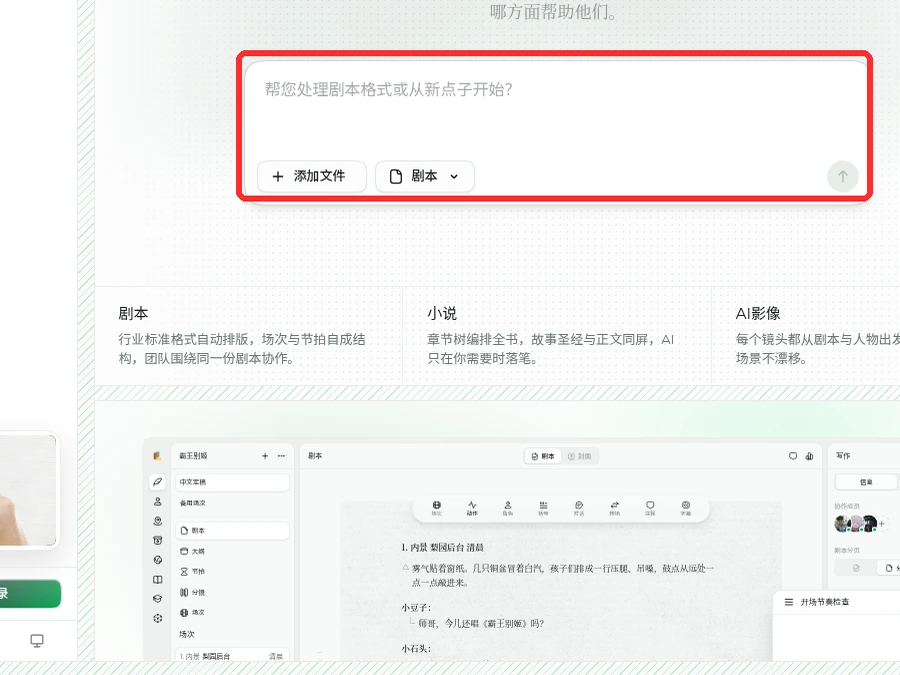
Laper 里“上传剧本”分两条路:手上的 Final Draft 文件走 FDX 导入,建一个新项目;DOCX、PDF、TXT、Markdown 从首页“添加文件”进,落到附件或知识库。FDX 才是剧本正文,其余四种都算资料。
还没账号?立即注册,登录后先看清楚要建哪种项目。
剧本要能排场次、拆镜头、生成人物,所以只认 Final Draft 的 .fdx。资料是给 AI 读的背景,字数再多也进不了正文。
先想清楚手上这份东西是哪一类。写完了的剧本是前者,设定集、调研、参考小说是后者。
打开 laper.ai 登录进去,左边栏是文档,右边那颗“登录”换成头像就说明进来了。
首页输入框左下角那颗“添加文件”,接的是 DOCX、PDF、TXT、Markdown。官方文档把这条入口叫灵感入口,喂的是简报和参考。
传进去 .fdx 不会被当成剧本解析。它只会变成一份附件,AI 能读,场次和人物不会自动长出来。
真正的剧本导入在“新建项目或导入 Final Draft”这条路上,从首页项目区进去,选导入。
导入会在浏览器里把文件解析一遍,再把结果交给新项目。进度条走完,正文就在编辑器里了。
文档写死这一条:只有 Final Draft 里 DocumentType=Script 的 .fdx 可以导入。
用 Final Draft 存的笔记、角色表、非 Script 类型文档都会被拒。导出前在 Final Draft 里确认文档类型。
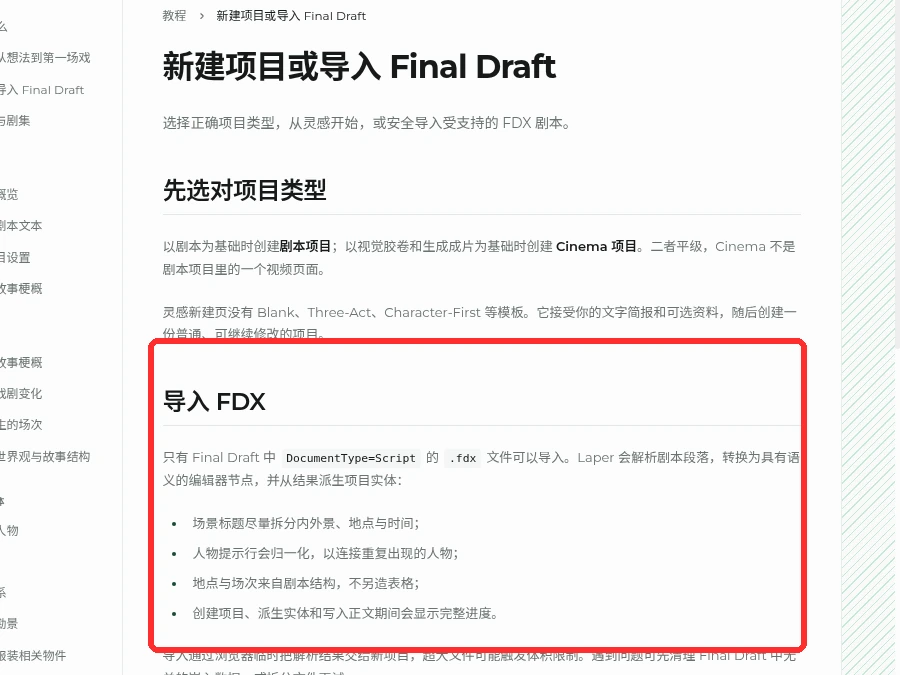
Laper 解析剧本段落,转成带语义的编辑器节点,再从结果派生项目实体。
场景标题会尽量拆出内外景、地点和时间;人物提示行会归一化,重复出现的人物连到一起;地点和场次直接从剧本结构来,不用另建表格。
这一步省掉大量手工录入,也意味着原稿里的写法会被改写一遍。特殊标题、特殊段落导入后要抽查。
导入过程在浏览器里临时转交解析结果,文件过大可能撞上体积限制。
撞上就先在 Final Draft 里清掉无关的嵌入数据,或者把剧本拆成几份分别导入。拆开导进去,后面再合并场次,比硬传一个几百兆的文件更稳。
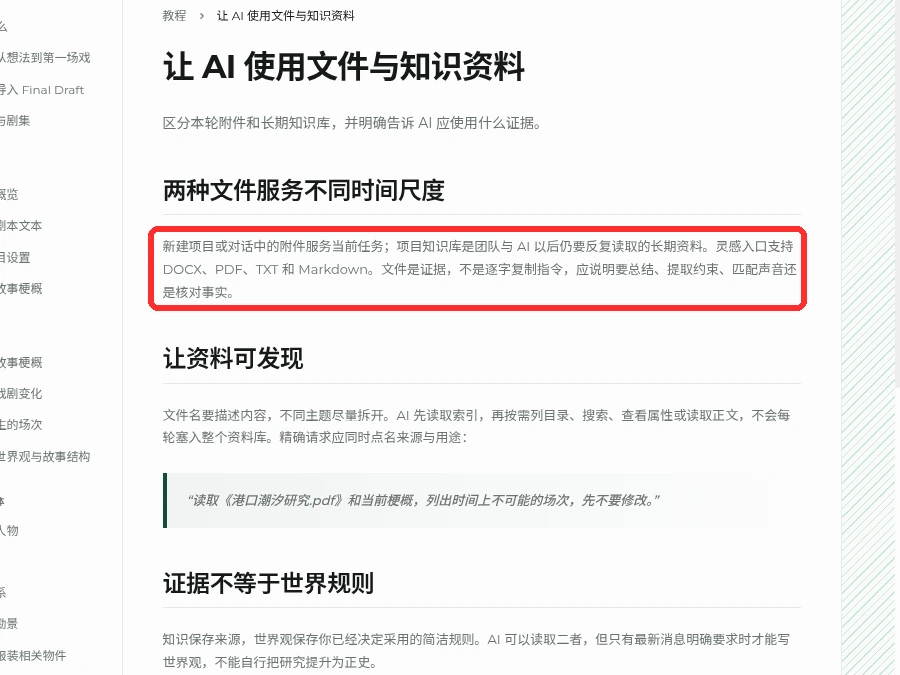
上传的资料分两种时间尺度。新建项目或对话里的附件只服务当前这一轮任务;项目知识库是团队和 AI 后面还要反复读的长期资料。
想让 AI 记住整季的设定,放知识库。只想让它看一遍这份 PDF 提几条意见,挂在这一轮的附件上就行。
AI 先读索引,再按需列目录、搜索、读正文,不会每轮把整个库塞进上下文。
所以文件名本身就是检索入口。写《第三集修改稿》这种名字,一个月后连你自己都分不清哪版是哪版。
Cinema 项目做的是视觉胶卷和生成成片,它不接 FDX。建项目那一步选错了类型,后面再传也是白传。
要剧本正文就建剧本项目。要分镜和成片另建 Cinema,两者是平级项目,不是一个套一个。
FDX 导入永远创建新项目,不会把外部修改合并回你正在写的那个项目。
在 Final Draft 里改了几场戏想同步回来,只能整份重导,再手工对齐。这条和官方格式表里写的导入导出边界是一回事,格式能过,内容不会自动同步。
导入完成先翻几个场景标题、重复人物和特殊段落。派生规则是自动的,写歪的地方也照单全收。
抽查完把改好的版本存成一个历史基线,后面改坏了能退回来。这套流程和AI剧本写作工作区里的日常操作接得上。
我用Laper改剧本时,会先选定一场戏或一段文本,再交代修改目标、人物动机和不能改动的设定。刚开始最容易踩的坑,是只说R...
2026-10-11
我用Laper整理剧本前期素材时,会先确认剧本里的角色、场景名称,再把角色肖像、地点参考和道具图关联到对应项目实体,最后选...
2026-10-11
Laper.ai分镜图卡住通常源于服务器过载、场景复杂度过高或网络连接不稳定。解决方法包括重新刷新页面、简化分镜描述、避开高...
2026-10-17laperai 和剧云哪个更适合短剧,看你缺剧本还是缺判断。按剧本和分镜出活选 Laper,要试拍片段验证节奏选剧云。Laper 的人物...
2026-10-24在 Laper AI 里写剧本,顺序是把人物名先写成对白行,让角色实体自己长出来,再用场景标题决定场景顺序,节拍放在大纲里对齐...
2026-10-25