
Muse Ember 是 Meta 超級智慧實驗室 2026 年 11 月 9 日發佈的小模型,型號 muse-ember-1.0,接的是智慧體一天裡反覆跑的那些活:工具調用、程式設計子任務、路由、資訊提取、長文件解析。在 Muse Code 和 Meta Model API 裡調,輸入每百萬 token 0.10 美元、輸出 0.50 美元,上下文 100 萬 token,單次最多輸出 51.2 萬 token。
官方給的定位是 Meta 至今體量最小、單位成本產出最高的模型,專門啃複雜推理的執行段和智慧體全天重複的活。
它不負責想方案。官方的分工說法是 Muse Wonder 規劃,Muse Ember 處理海量任務;客服智慧體裡,重模型先定處理規則,Ember 拿著規則跑幾萬個工單。
發佈時間按官方部落格寫的是 2026 年 11 月 9 日,中文媒體按北京時間記成 11 月 10 日,差的是時區。
它是第一個用 Muse Wonder Full 訓練出來的模型,官方叫法是訓練自旗艦,能力從旗艦往下蒸餾,再按高頻小任務裁剪。
三個價目:輸入每百萬 token 0.10 美元,快取命中過的輸入 0.004 美元,輸出 0.50 美元。快取價是輸入價的 4%,反覆喂同一份長文件時差價從這一項出。
上下文 100 萬 token,單次最多吐 51.2 萬 token。一次調用裝得下一整個程式碼庫,或者一整套合同與文件。
快取那檔價格對應的是重複輸入。同一份系統提示詞、同一批合同第二次進來只收原價的 4%,批次跑同類任務時差價從這一項出。
介面走 Responses API,模型名就寫 muse-ember-1.0。上線當天能用的地方有兩個:Muse Code 和 Meta Model API。
這套規格對著的是智慧體場景裡那類跑幾百遍的小任務,不是給人寫長文用的。官方舉的例子是讀檔案、跑測試、按報錯做定向修復。
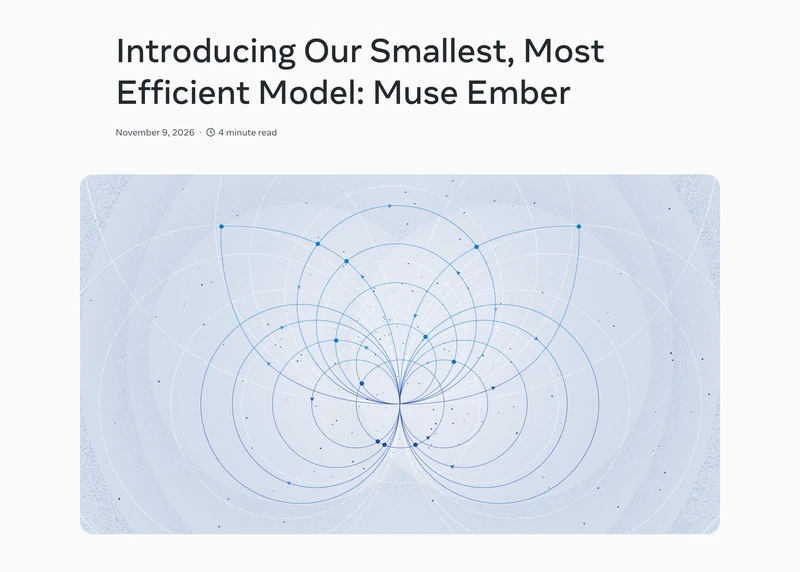
官方引的是 Artificial Analysis 2026 年 11 月 9 日的資料,橫軸是單任務成本,縱軸是綜合智慧指數,每個點是一檔推理強度。
| 模型與檔位 | 智慧指數 | 單任務成本 |
|---|---|---|
| Muse Ember max | 35.8 | $0.136 |
| Muse Ember xhigh | 33.9 | $0.116 |
| Claude Haiku 5.5 max | 36.2 | $0.411 |
| Claude Haiku 5.5 high | 29.6 | $0.159 |
| GPT-6 Luna max | 27.8 | $0.152 |
表裡最值得看的一對是 35.8 和 36.2。Ember 花 0.136 美元拿到 35.8 分,Haiku 要到 0.411 美元才有 36.2 分,0.4 分的差距對應 3 倍的錢。
另一頭是 Luna。它在 0.152 美元的檔位上只有 27.8 分,比 Ember 貴 1 毛錢的任務反而少 8 分。
官方註明這張表是拿各家標價估出來的,不是賬單實測;真實花費還要看快取命中率與輸出長度。

AutomationBench-AA 測端到端業務流程:取記錄、按順序做工具調用、跨應用改系統狀態。Ember 37.8,Haiku 5.5 是 13.9,Luna 20.2,這一項差了 23.9 分。
Agents’ Last Exam 測長鏈路任務,三方擠在一起:61.6、57.0、57.1,Ember 只多出 4 分多。
Personal Superintelligence Index 是官方自己拼的綜合指數,覆蓋個人事務與知識工作,Ember 46.8 對 36.1 和 37.0。
三張圖的分數都取各模型的最高推理檔,橫向比才成立。拿 Ember 的 max 檔去對別家的低檔,分差會虛高,成本那一欄也會失真。

Terminal-Bench 4.0 按各家公開的 harness 配置跑,Ember 40.9,Haiku 39.2,Luna 16.4。差距不大,但這一項 Ember 站在前面。
Coding Agent Index-AA 把模型放進真實 agent 骨架裡跑,46 對 37 對 31。
FrontierCode 2.0-AA 換了個評判口徑:改動能不能被項目維護者合併。這一項 Ember 27.2,Haiku 34.9,Luna 25.2,是整套評測裡 Ember 唯一落後 Haiku 的一項,差 7.7 分。
把三項放在一起能看出取捨:按 harness 跑任務、在骨架裡連續動手,Ember 站得住;要交一份能過審的補丁,它的通過率還不如貴三倍的模型。
0.10 美元的輸入價撐的是頻次。一個會話裡跑幾百次讀檔案、跑測試、按報錯改幾行,單價高一點的模型在這種循環裡燒錢,Ember 的設計目標就是這一段。
文字、圖像、音訊、影片四類輸入原生支援,輸出只有文字。截圖、圖表、掃描件進得去,語音備忘、會議錄音、影片素材也進得去,不用再掛一個轉寫模型。
GDP.pdf-AA 測長文件裡的專業工作,Ember 22.8,Haiku 20.8,Luna 22.8,三家打平。
OSWorld 2.1 測在桌面應用裡操作電腦,按部分給分是 69.5、68.9、50.5,按二值給分是 33.8、27.8、17.0。兩種口徑都只差不到 1 分。
PerceptionBench 測細粒度視覺感知,配工具跑:80.6、78.6、62.8。

Meta 的 Muse 系列現在分三層。Wonder 接最難的問題,Spark 接程式設計與智慧體工作流,Ember 接能規模化重複執行的編碼與智慧體任務。
| 模型 | 接的活 | 上線時間 |
|---|---|---|
| Muse Wonder | 最難的問題 | 2026 年 10 月 |
| Muse Spark | 程式設計與智慧體工作流 | 2026 年 4 月 |
| Muse Glimmer | Spark 的開源版 | 2026 年 8 月 |
| Muse Ember | 規模化重複執行的編碼與智慧體任務 | 2026 年 11 月 |
同一時期還有消費端產品:Muse Agent 在 9 月上線,本月加了 Spaces 與影片聊天。
拿 Muse Spark 1.3 對照最直觀。智慧指數 37 比 36,單任務成本 2.39 美元對 0.14 美元,價格 1.25 與 4.25 對 0.10 與 0.50。多 1 分,貴 17 倍。

import os, requests

url = os.environ["META_API_BASE"] + "/v1/responses"
headers = {"Authorization": f"Bearer {os.environ['META_API_KEY']}"}
payload = {
    "model": "muse-ember-1.0",
    "input": "把這份合同的違約條款逐條比對我們的談判手冊,標出偏差",
    "input_file_ids": ["file_xxx"],
}
res = requests.post(url, headers=headers, json=payload, timeout=300)
print(res.json()["output"][0]["content"])
介面地址與欄位名以官方文件當天頁面為準,Responses API 這一套和各家的同名介面不完全一致。
上線前按 Meta Superintelligence Scaling Framework 跑了一遍,覆蓋化學與生物、網路安全、失控三類風險,結論都低於框架裡的高風險閾值。小模型也走了同一套核心安全訓練與測試。
另有一組針對代理行為的評估:是否按使用者意圖辦事,敏感資訊怎麼處理,網頁、文件、工具返回裡夾帶的指令能不能頂住,高風險動作前會不會先問人。
首批把它放進真實業務的夥伴是 Box、Cline、Oracle、Cloudflare、You.com。Box 那邊用在合同審查與候選人篩選,Cline 用在編碼子任務上。
Meta 同時放話還有更省的模型在訓,Ember 是這條線的第一顆。
Claude Duet和Dots、Muse都是同一類東西:帶權限的個人代理,都能讀你授權的應用、在後台幹活、對外動作前要你點頭。真正要取...
2026-10-22
Muse Spark Open 是 Meta 於 10 月 15 日開源的多模態大模型,816B 參數(42B 啟用)、100 萬 token 上下文、支援文字和圖像...
2026-10-16
muse 的主動記憶指的是它會自動保留跨會話的偏好和上下文,不需要每次重複交代背景。這類記憶讓它在長期任務上比普通對話順手...
2026-10-16
muse 是 Meta 推出的個人 AI 智慧體產品,Meta AI 則是它底層更寬泛的助手品牌,兩者共用同一套模型能力但定位不同。muse 強...
2026-10-16
千問Go、Muse和N1 Pro都屬於個人AI助理,最大的差別在入口形態,而不是能不能替你辦事。一個內嵌在手機App裡,一個是獨立應用...
2026-10-14