
Piccolo 是阿里 AgentScope 团队 2026 年 10 月 30 日开源的决策模型,分 27B、9B、4B 三档,Apache-2.0。输入是当前状态、一个问题、几个候选项,输出是一个选择和每个选项的概率,不生成文字。27B 在 JevBench Public 上 92.21%,11 个模型里排第一。打开 decisionplayground.agentscope.io 能直接试,本地跑走 QwenPaw。
官方叫它决策模型(decision model)。它不做对话,只做判断:给定状态、问题、候选项三段,从候选项的 token logits 里读出概率,返回程序能直接用的结构化结果。
要看懂它占的位置,先看 Harness。Harness 是模型外的一层运行系统,管会话历史、管工具调用、管代码在哪跑、管失败重试。它每走一步都要判断一次:调哪个工具、用哪个模型、哪些上下文留着、这个操作越不越权、任务算不算做完、失败了要不要重试。这些判断现在大多丢给通用大模型,输出一段文字再解析回来。
Piccolo 把这一步单独做成模型:不写文字,只给选择。
| 项目 | 通用对话模型 | Piccolo |
|---|---|---|
| 输入 | 一段提示词 | 状态、问题、候选项三段 |
| 输出 | 文字 | 一个选择加每个选项的概率 |
| 接口 | /v1/chat/completions | /v1/systemone |
| 单次开销 | 按输出 token 计 | 不产生 token,只读候选位 logits |
| 用在哪 | 写内容、答问题 | 工作流里反复出现的判断点 |
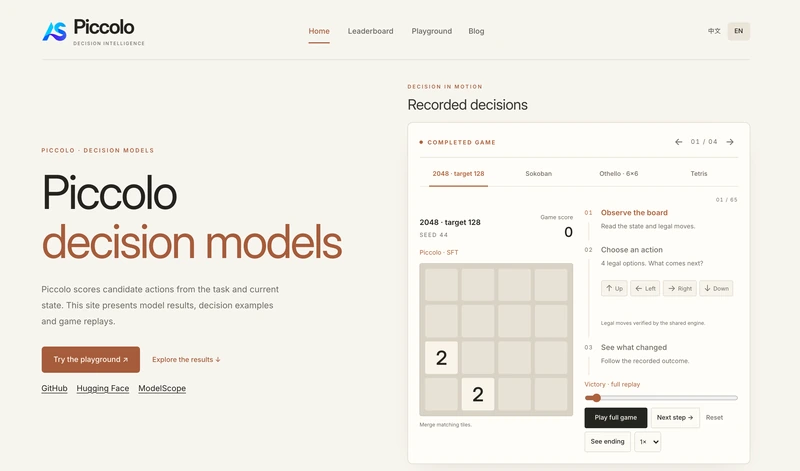
三个尺寸全部开源,12 个 Hugging Face 仓库,含完整权重和三档 GGUF(BF16、Q8_0、Q4_K_M),Apache-2.0,没有调用费,成本在自己的机器上。
两个原因。一是输出形态:返回的是每个候选项的概率,程序可以直接排序、卡阈值、按预算剪枝,不用先解析一段文字再猜格式。二是不按输出长度计费:判断开销只跟输入长度和候选数有关,不随回答写多长变化。
原生端点是 /v1/systemone,返回的是结构化决策加各选项概率。Arena 也不另起,沿用 JevArena,jev.* 协议和回放 ID 都保留。
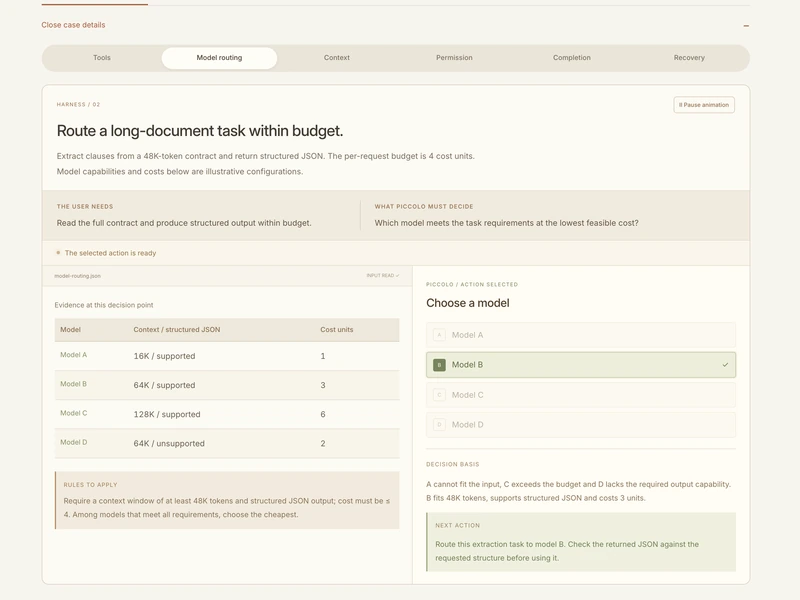
官方放了 9 个回放:马里奥的移动与跳跃、2048 的合并方向、推箱子的箱子分配、黑白棋落子、俄罗斯方块摆位、《绝区零》战斗的 95 秒连打。每个回放能暂停、拖动、逐条看当时每个候选动作的概率。
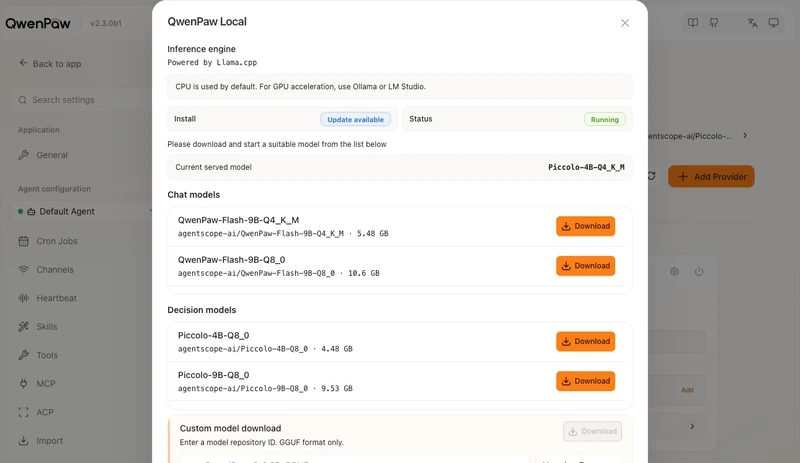
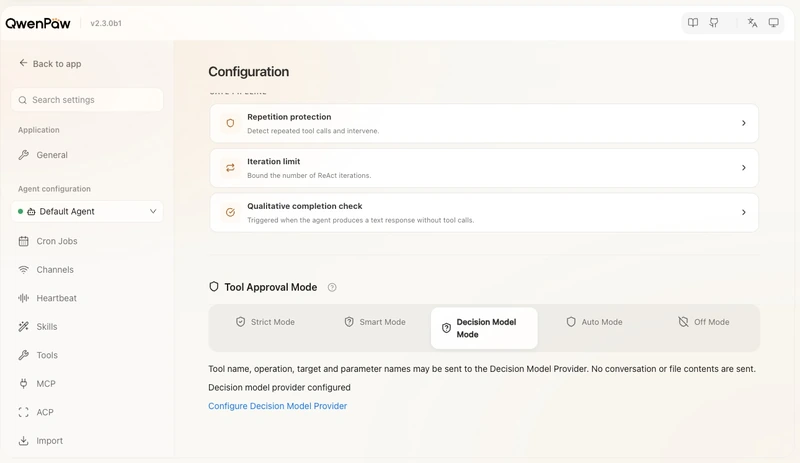
第 4、5 步有个坑:模型 Start 起来不等于功能打开,两个开关要各自单独开。本地运行时同时只服务一个模型,聊天可以另接别的 provider。
JevBench 是第三方决策基准,231 道题,11 个模型跑同一套题。四个基准里,27B 都是第一。
| 基准 | 27B | 9B | 4B |
|---|---|---|---|
| JevBench Public v1.2 231 题通用决策 |
92.21% | 89.61% | 87.01% |
| Decision Index 文本 Public 0 到 100 判断 |
68.59 | 60.86 | 58.29 |
| HarnessJevBench Hard v0.5 295 个运行控制用例 |
84.41% | 70.68% | 63.22% |
| DataJevBench v0.5 500 个数据用例 |
82.60% | 69.20% | 71.20% |
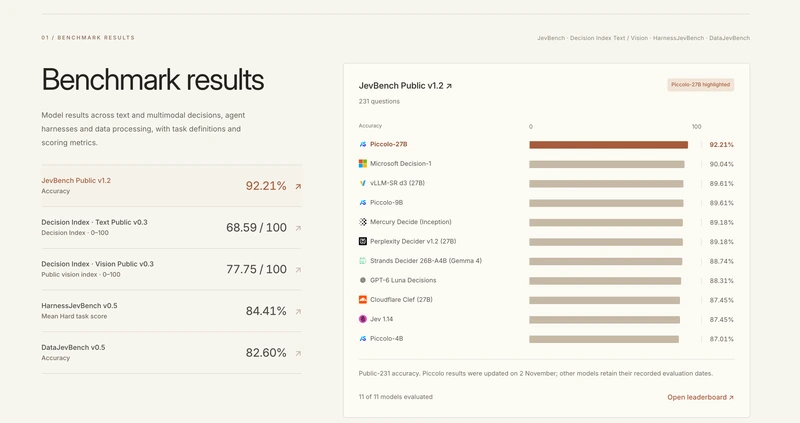
JevBench Public 上的 11 个模型排位:
| 排名 | 模型 | 准确率 |
|---|---|---|
| 1 | Piccolo-27B | 92.21% |
| 2 | Microsoft Decision-1 | 90.04% |
| 3 | vLLM-SR d3 (27B) | 89.61% |
| 4 | Piccolo-9B | 89.61% |
| 5 | Mercury Decide | 89.18% |
| 6 | Perplexity Decider v1.2 (27B) | 89.18% |
| 7 | Strands Decider 26B-A4B | 88.74% |
| 8 | GPT-6 Luna Decisions | 88.31% |
| 9 | Cloudflare Clef (27B) | 87.45% |
| 10 | JEV 1.14 | 87.45% |
| 11 | Piccolo-4B | 87.01% |
准确率之外还有两列:Brier 和 ECE,越低越好。Piccolo-27B 的 ECE 是 0.0412,11 个模型里排第 5,比 vLLM-SR d3 的 0.0217、Microsoft Decision-1 的 0.0224、Perplexity Decider 的 0.0261 都差,也比自家 9B 的 0.0268 差。选得最准,但给的概率没那么可信。要拿概率做阈值,得先在自己的数据上标定一遍。
27B 四项都是第一,权重也最大。9B 和 4B 的差别不在大小上:HarnessJevBench 里 9B 比 4B 高 7.46 个点,DataJevBench 里 4B 比 9B 高 2 个点。跑 Agent 运行控制取 9B,只做数据工作流里的判断取 4B,它的 Q8_0 权重是 4.48 GB。
训练被做成一个数据迭代循环:诊断,选数据和造数据,训练评测,更新下一轮配方。
这条管线、两个自建基准、Arena 全部开源,能复现。
发布日期:模型卡和官网博客标的是 2026 年 10 月 30 日,成绩在 11 月 4 日更新过一版。
即梦把已经拍好或者生成好的视频重新画一遍,靠的是参考视频模式:上传原片当依据,再写目标风格的提示词,模型在保留原片节...
2026-10-16
即梦的字幕不是独立开关,它跟随项目里的文本信息走:在脚本或台词框里写下内容,生成视频时选择是否把文字烧进画面。想改字...
2026-10-16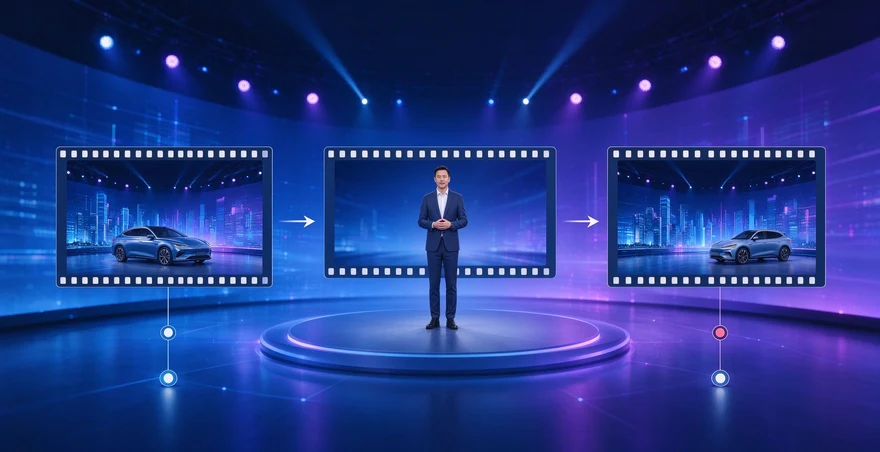
即梦的视频模板替换人物,做法是先选一个带场景和动作的现成模板,再把模板里的人物形象换成自己提供的素材。替换人物靠的是...
2026-10-16
即梦生成的视频显得假,通常是三个环节没做对:素材本身太糊、提示词写得太抽象、模型和参数没匹配场景。想提升真实感,先把...
2026-10-16
PixTV里音频走的是“上传素材加时间轴对齐”这条路:先把音频文件传进项目,再把它拖到时间轴的音轨上,和画面段落对齐。它支持...
2026-10-16