
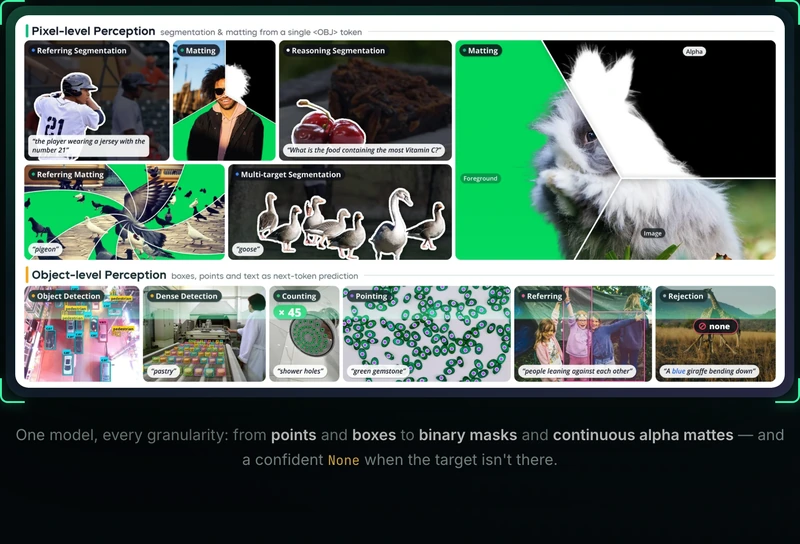
WeVisOne-VL 是腾讯微信视觉团队 2026 年 10 月 23 日开源的视觉语言模型,2B 和 4B 两档,代码 Apache-2.0,基座是 Qwen3-VL。它把目标检测、指代定位、计数、点标注、OCR、指代分割和提示式抠图放进一个模型,输出可以是点、框、二值掩码或 alpha 蒙版,目标不存在时返回 None。项目页在 tencent.github.io/WeVisOne-VL,权重在 Hugging Face 的 tencent/WeVisOne-VL-4B 和 tencent/WeVisOne-VL-2B。
名字拆开是 WeChat Vision All-in-One。它做细粒度视觉感知,不做开放式对话:给一张图和一句查询,返回查询目标的位置或者像素。
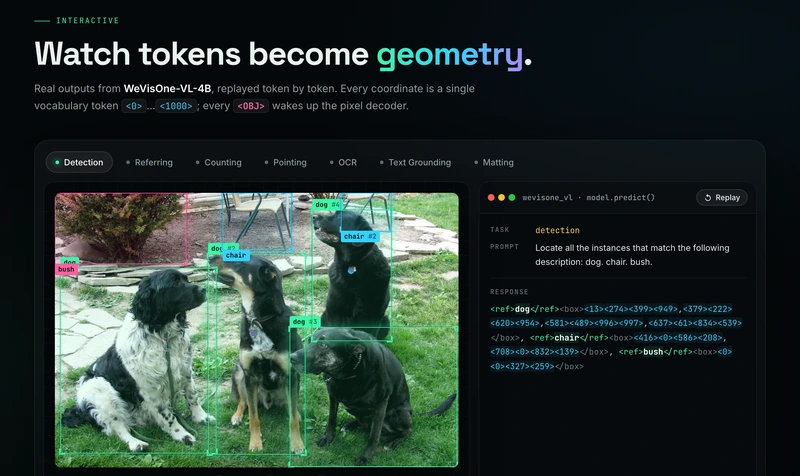
位置用坐标 token 表示。<0> 到 <1000> 共 1,001 个专用 token 编码归一化坐标,一个框占 4 个 token,一个点占 2 个。
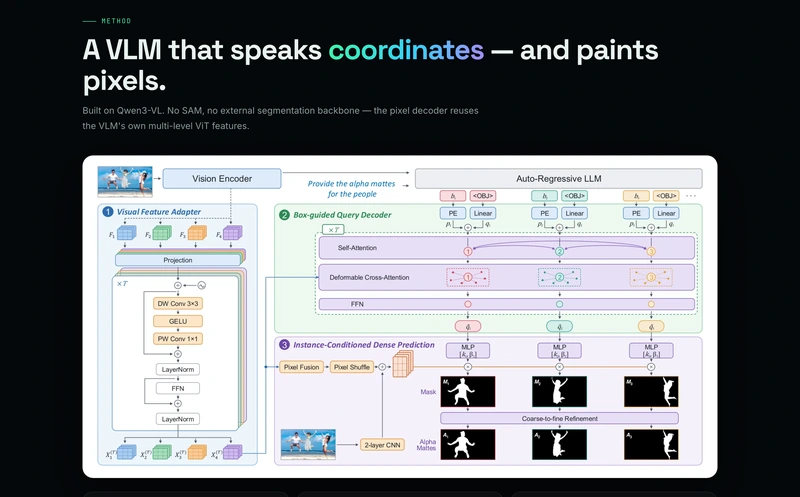
像素结果由 9.6M 参数的解码器出,挂在语言模型吐出的 <OBJ> token 后面。解码器不接第二个图像编码器,直接取 Qwen3-VL ViT 的四层 pre-merge 特征,所以分割和抠图不用外挂 SAM。解码器内部分三段:视觉特征适配器做投影、6 个 deformable cross-attention 用 <OBJ> 隐状态和框当 query、稠密头按 S/4 到 S/2 到 S/1 逐级细化成全分辨率掩码。
task 参数有九个取值,query 按任务填类别列表或自然语言描述:
| task | query 填什么 | 输出 |
|---|---|---|
| detection | 类别列表 | 每个实例的框 |
| referring | 自然语言描述 | 框,或 None |
| point | 类别 / 描述 | 坐标点 |
| count_box | 类别 / 描述 | 框,加数量 |
| count_point | 类别 / 描述 | 点,加数量 |
| ocr | 空 | 文字和文本框 |
| ocr_grounding | 要查找的文字 | 文字和文本框 |
| segmentation | 类别 / 描述 | 框加二值掩码 |
| matting | 类别 / 描述 | 框加 alpha 蒙版 |
只做文档转 Markdown 或 JSON 的时候,Xiaomi-OCR-0 那类文档解析模型更对口,它出的是结构化文本,不是框和掩码。
git clone https://github.com/Tencent/WeVisOne-VL.git
cd WeVisOne-VL
conda create -n wevisone-vl python=3.10 -y
conda activate wevisone-vl
pip install -r requirements.txt
pip install -v -e .from wevisone_vl import WeVisOneVL
model = WeVisOneVL(
"tencent/WeVisOne-VL-4B",
backend="transformers",
)result = model.predict(
image,
task="detection",
query=["sofa", "pillow"],
)
result = model.predict(
image, task="matting", query="person"
)
CUDA_VISIBLE_DEVICES=0 python demo/app.py \
--model tencent/WeVisOne-VL-4B4B 版本在官方表里的九项关键指标,对比列是各榜开源基线里的最好成绩:
| 任务 | 基准 | 指标 | 基线最好成绩 | 4B |
|---|---|---|---|---|
| 目标检测 | LVIS | 平均 F1 | 50.7 | 55.3 |
| 密集检测 | Dense200 | 平均 F1 | 58.7 | 71.3 |
| 指代检测 | RefCOCOg test | 平均 F1 | 77.6 | 81.8 |
| 目标计数 | PixMo-Count test | 准确率 | 82.8 | 89.6 |
| 点标注 | PointBench | 准确率 | 69.9 | 71.9 |
| OCR | TotalText | 平均 F1 | 43.3 | 52.0 |
| 指代分割 | ReasonSeg val | gIoU | 65.0 | 71.2 |
| 框提示抠图 | P3M-500-NP | MAD 越低越好 | 15.4 | 7.3 |
| 文本提示抠图 | WeRefMat | MAD 越低越好 | 22.4 | 9.8 |
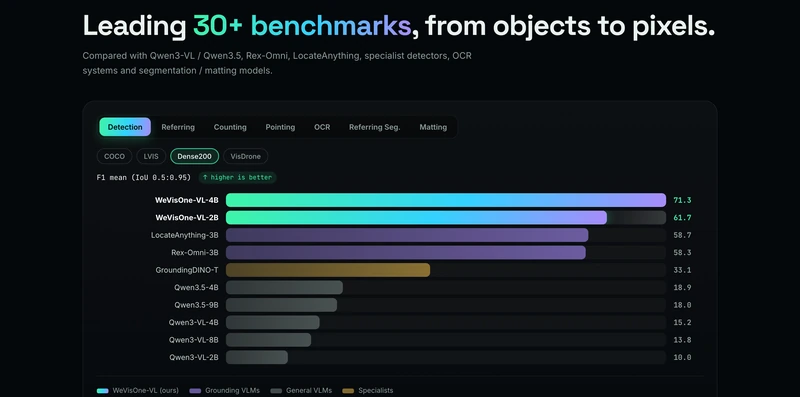
检测、指代、OCR 的 F1 按 IoU 0.5 到 0.95 取平均,贪心解码。这些数字都出自腾讯自己的评测表,目前没有第三方复现。
两个权重在 Hugging Face 上标的是 2.44B 和 4.83B 参数。官方单独给了 2B 在 Dense200 的分数,61.7,比 4B 低 9.6 个点。抠图反过来:P3M-500-NP 的 MAD 2B 是 6.6,4B 是 7.3,这项越低越好。要跑密集检测、OCR、指代定位取 4B;只做抠图和主体分割,2B 更小也更准。
数据来自一条知识图谱驱动的标注管线:SAM3、Rex-Omni 和自研检测器提候选区域,Qwen3-VL 核验,核验过的框再扩成掩码和 alpha 蒙版,累计 1 亿张以上图像。把掩码转成透明蒙版的标注器按 mask2alpha 分支单独开源。
训练是三段 SFT 接一段强化学习:
| 阶段 | 样本量 | 做的事 |
|---|---|---|
| SFT 第 1 段 | 9,020 万 | 对齐输出格式 |
| SFT 第 2 段 | 4,050 万 | 提到 1,960 个视觉 token,单次最多 500 个框 |
| SFT 第 3 段 | 4,180 万 | 训像素解码器,之后在 1.3 亿样本上专训抠图 |
| GRPO | 17.8 万 | 混合任务强化学习,按不确定度筛样本 |
训练上下文 8,192 token。报告里没给部署时的上下文上限,也没给显存占用。
仓库首次公开提交在 2026 年 10 月 23 日,README 在 10 月 25 日更新过一版。

阶跃星辰API接入的核心步骤包括三个方面:在开放平台注册并获取API Key,根据所需模型选择调用方式,通过代码示例快速集成。...
2026-10-13
即梦文生图怎么更准确,核心在于提示词结构、参数设置和参考图的合理运用。用户需要在提示词中清晰定义主体、描述、风格和上...
2026-10-13
即梦电脑版无需下载安装,直接在浏览器访问jimeng.jianying.com即可使用全部功能。即梦AI采用网页版优先策略,Windows、Mac、...
2026-10-13
即梦AI是否收费?答案是既有免费额度也提供付费会员。作为字节跳动推出的一站式AI创作平台,即梦通过积分制管理资源消耗。非...
2026-10-13
即梦提示词是用户向AI输入的指令描述,用来引导AI生成符合预期的图片或视频内容。提示词质量直接决定生成效果的满意度,掌握...
2026-10-13