
文心5.5 Flash Base 是百度 2026 年 11 月 5 日开源的稀疏 MoE 语言模型,总参数 2800 亿、每 token 激活 140 亿,只开放预训练终点的权重,没做中训练和后训练,可用于领域适配、指令微调与强化学习。权重在 Hugging Face 的 baidu/ERNIE-5.5-Flash-Base,FP8 与 BF16 两版,说明页在 ernie.baidu.com/release/ernie-5-5-flash-base。
它是文心这一代的开源基座,用于下游训练。同代的对话产品是文心一言,这一版去掉对话能力,只留预训练出来的底座。
| 项目 | 数值 |
|---|---|
| Transformer 层数 | 43 |
| hidden size | 4096 |
| 注意力头 | 64 |
| MoE 层专家 | 512 个路由专家 + 1 个共享专家,每次激活 10 个 |
| 专家隐空间维度 | 2048 |
| 词表 | 20 万 |
| 预训练 token | 33.5T |
43 层里第一层的 FFN 是稠密块,其余各层是 MoE 块。每个 MoE 层先把 token 从 4096 维投到 2048 维隐空间,专家在里面计算,再由一次共享上投影投回原维度,dispatch 与 combine 的通信量、专家 FLOPs 各减一半。
上下文长度按阶段分开:预训练最长 128K,微调和推理到 1M。
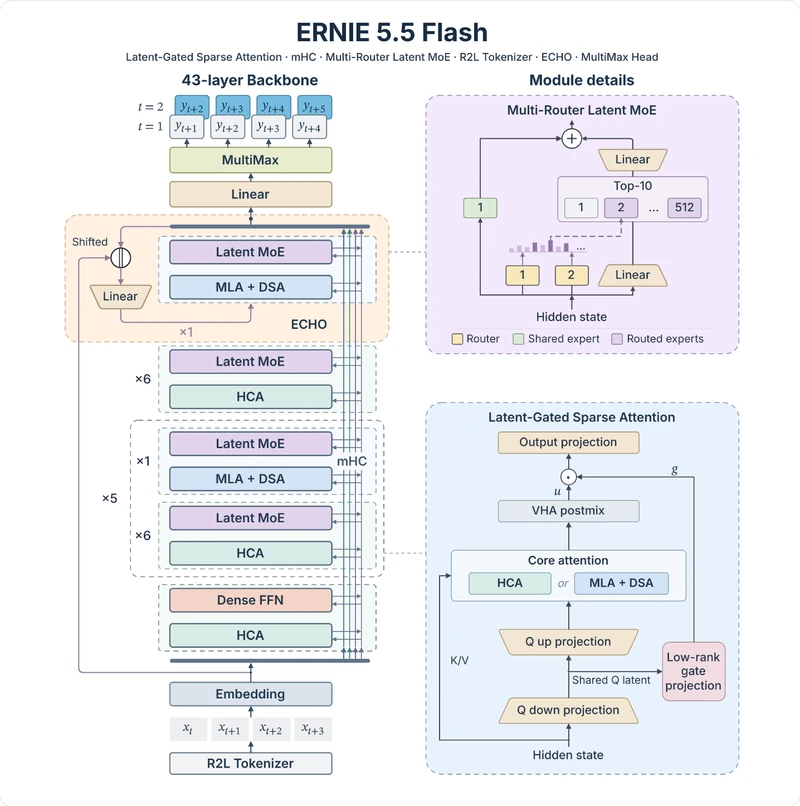
注意力层里只有 6 层保留全上下文访问,其余 37 层在压缩后的序列上算。
头维度随层类型不同:HCA 层在 128 倍压缩后的序列上算,用 512 维头;MLA 层逐 token 算,query/key 与 value 用 256 维头。KV cache 预算集中给 6 层 MLA,不给先压 4 倍再稀疏选位置的 CSA 层,官方在同等预算的预训练对比里测出 HCA 配 MLA 的分数高于配 CSA。
注意力内部另有两处改动。低秩门控把输出门的输入换成注意力层自己生成的低秩 query latent,维度只有隐状态的四分之一,门投影参数量减 75%。VHA 在注意力之后做一次带恒等跳连的跨头低秩混合,推理时并进算子。
单路由器在中深层的问题:打分和专家实际效用弱相关,落选的专家拿不到梯度。这一版换成 Multi-Router,多个独立初始化的 sigmoid 路由器一起打分,各路由器的偏好分化,一个专家被一个路由器打高分、或被几个同时打高分,都能入选。激活专家数、专家 FLOPs 和通信量不变。
残差连接换成 mHC,每层用受约束的混合矩阵读写 4 条并行残差流。输出头换成 MultiMax,用分段可学习温度,压掉不合理 token 的长尾,保留合理候选,logits 在 Triton 融合的交叉熵 kernel 里、softmax 之前调制。
多 token 预测原本要在主干上挂一个专用模块,多步损失只监督那个模块。ECHO 改成复用主干最后一层:让主干自己预测后续 token,多步损失直接打在生成下一个 token 的参数上。
官方只训一步 ECHO。这一层能当投机解码的草稿模型,同样训一步,多步起草的质量高于外挂 MTP。
分词器同时更换:数字按从右到左、最多三位一组切,1,234,567 切成 1 / 234 / 567,位数对齐,算术和数字密集的文本切出的 token 数变少。
训练侧改了两处,分布式 Muon 优化器和 FlashMask-4 注意力算子。
对比对象是发布时同规模的开源 Base:DeepSeek 的 V4 Flash Base(284B-A13B)、Hy3-preview-Base(295B-A21B)、MiMo-V2.5-Base(310B-A15B)。四家用各自公开的 checkpoint,同一套评测框架、同一批 prompt 与 few-shot 样例,问答题用同一个裁判模型。
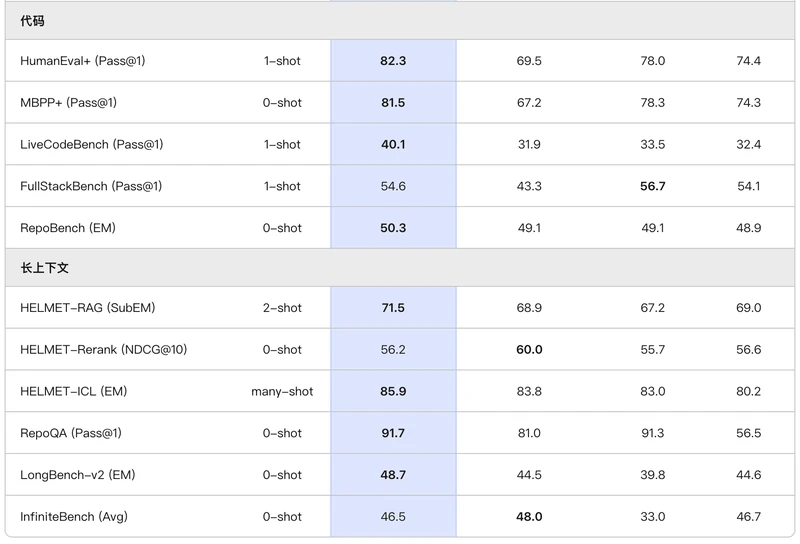
下表四列依次是文心5.5 Flash Base、DeepSeek V4 Flash Base、Hy3-preview-Base、MiMo-V2.5-Base,参数之后按综合、知识、理科、推理、多语言、代码、长上下文各取一项。
| 项目 | 文心5.5 | DeepSeek V4 | Hy3 preview | MiMo V2.5 |
|---|---|---|---|---|
| 总参数 | 280B | 284B | 295B | 310B |
| 激活参数 | 14B | 13B | 21B | 15B |
| MMLU | 93.3 | 89.4 | 87.5 | 87.6 |
| MMLU-Pro | 78.4 | 69.2 | 66.9 | 65.7 |
| CMMLU | 90.0 | 89.7 | 89.3 | 87.7 |
| PopQA | 52.2 | 48.7 | 49.3 | 45.7 |
| GPQA | 60.2 | 55.9 | 50.2 | 51.4 |
| BBH direct | 77.1 | 69.0 | 67.5 | 68.0 |
| MMMLU-lite | 81.0 | 78.5 | 76.1 | 72.2 |
| HumanEval+ | 82.3 | 69.5 | 78.0 | 74.4 |
| LiveCodeBench | 40.1 | 31.9 | 33.5 | 32.4 |
| HELMET-RAG | 71.5 | 68.9 | 67.2 | 69.0 |
30 项里 24 项高于对比模型,综合、理科、推理、代码四块分数都在四家里最高,差距最大的是 MMLU-Pro,比第二名高 9.2 分。
低于对比模型的 6 项:ChineseSimpleQA 73.0,DeepSeek 75.3;INCLUDE-lite 79.5 对 79.8;BBH CoT 89.2,Hy3 90.0;FullStackBench 54.6,56.7;HELMET-Rerank 56.2,60.0;InfiniteBench 46.5,48.0。
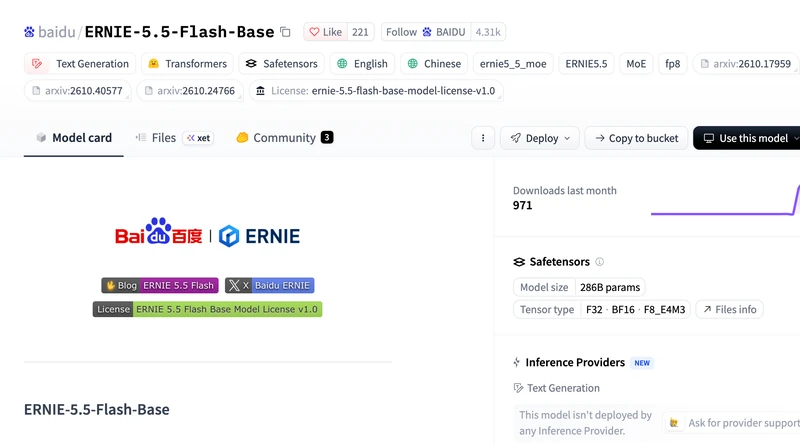
两个仓库都在 Hugging Face。模型卡标 286B 参数、F32 与 BF16 与 F8_E4M3 三种张量类型,许可为 ERNIE 5.5 Flash Base Model License Agreement v1.0。
PixPix不支持国内登录吗?能注册也能用,卡点在网络和支付;邮箱就能注册,不要求国内手机号。打不开多半是线路问题,不是账...
2026-10-18
PixPix批量标注亚马逊图片教程:先把待处理的图统一成同一规格塞进一个任务,再批量提交;标注文字用短词比长句稳。规格不统...
2026-10-18
PixPix精修教程:先修构图再修光,最后才修细节;每次只改一项再对比。参数叠着一起调,改坏了分不清是哪一步出的问题,只能...
2026-10-18
PixPix生成电商主图用哪个模型?商品要清楚就选通用款,要氛围和场景再换场景款。主图的第一要求是商品可辨认,画面好看排在...
2026-10-18
PixPix出来效果不满意怎么修改?局部问题用局部重绘,整体跑偏才重生成。构图和风格不对属于跑偏,边缘和细节属于局部,分错...
2026-10-18