dots.tts.edit V1.1:小红书的语音编辑模型 改一句话不用重录 组合编辑成功率 42.92%
更新时间:2026-11-14 08:29:33 发布时间:6小时前 阅读:11次
dots.tts.edit V1.1 是小红书开源的语音编辑模型,代码与权重都是 Apache-2.0。用法是拿现成录音,把要改的字句写成带标签的指令提交,模型只重新生成被改动的那一段,其余波形与音色保持原样,不用重录整条音频。在官方基准 doteBench 上,组合编辑整条指令全部完成的成功率是 42.92%,同表最高开源基线是 18.33%;支持中英文与多说话人,一次生成可同时执行文字替换、情绪、语速和停顿的多处修改。
dots.tts.edit V1.1 改的是录音里的局部片段
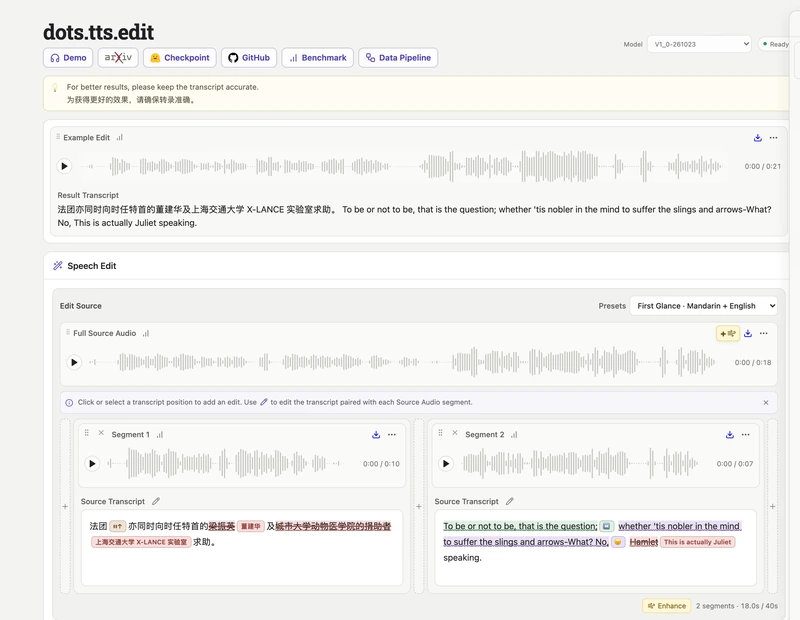 dots-studio-dots-tts-edit.hf.space 首屏(截图日期 2026-11-13),示例素材是一段中英混说的双人录音
- 任务是改已有录音,不是重新合成。整段合成会得到一条新音频,编辑动的是原文件里的几个字或几秒钟。
- 输入有三样:源音频、带标签的编辑指令、输出路径。源转录与目标转录可以不给,模型从指令里推导。
- 四类控制写进同一套接口:文本、情感、音高与语速、停顿。组合编辑指这四类里的几项在同一次生成里一起改。
- 有声书、广播剧这类多角色配音的素材,过去改一个字要重录整段,编辑模型把改动限制在被选中的片段内。
- 仓库 studio-dots-ai/dots.tts 里放着语音合成与语音编辑两套代码,建仓时间是 2026 年 6 月 4 日,11 月 13 日抓到 1,420 star、148 fork。
- README 的记录是 2026 年 8 月首发 dots.tts.edit,9 月放出 doteBench V1.0,10 月上线 V1.1,新增自由形式的风格描述编辑,并改进了韵律与情感编辑。中文发布稿另给了中英混说的双人演示与试听页面。
dots.tts.edit V1.1 的指令按转录位置绑定
- 指令是半形式化的 XML 标签,标签名表示操作类型,属性写参数,标签位置表示作用在哪段文字上。
- 文本改动有三个标签:
<sub targ="replacement"> 替换、<del> 删除、<ins> 插入。
- 声音侧五个:
<emo> 情感可以带 desc 属性写自然语言描述,<pitch> 音高、<rate> 语速、<pause/> 停顿、<spk_transfer/> 说话人迁移。
- 另有
<enhance> 与 <bg>,分别处理语音增强与背景声。
- 论文把这种写法叫 transcript-grounded,意思是指令绑在转录的文字位置上,不绑时间戳。
- 不带时间戳的后果是模型不需要外部对齐器,也不需要单独预测时长,靠结束信号 EOS 决定什么时候停。
- 论文里对比过自然语言指令:同样初始化、同样数据、同样步数下,XML 版本把 Text Hard 的编辑错误从 14.73% 降到 14.45%,停顿方向准确率从 69.33% 提到 92.00%,组合编辑的整条成功率从 26.67% 提到 37.92%。
- 指令写错或推导出空转录的请求会被拒绝,不进入生成。
dots.tts.edit V1.1 的模型结构沿用 dots.tts
- 初始化自 dots.tts 的 2B 参数 checkpoint,编辑与合成共用一套参数,编辑时多看源文本、源语音、指令和目标文本四个条件。
- 主干是 Qwen2.5-1.5B 语言模型、24 层语义编码器、18 层自回归流匹配 DiT,DiT 作用在冻结的 48 kHz AudioVAE 的 4 帧 patch 上。
- 音色条件来自 512 维 CAM++ 说话人编码器,用的是 VoxCeleb 训练的权重,这一层在训练中不更新。
- 全流程没有离散 token,语音在连续隐空间里生成,冻结的 AudioVAE 工作在 48 kHz。
- 训练数据按操作类别分开造:文本约 1,100 万对、情感约 1,000 万对、韵律约 800 万对、停顿约 500 万对。
- 编辑数据与合成数据按 24:2:2:1.2:0.7 的比例混合,合成部分取自基座用的 150 万小时语料,作用是让模型在局部编辑监督之外继续接触整句合成样本。
- 60% 的编辑样本由两到三段独立音频拼接而成,总长不超过 40 秒,其中包含多说话人拼接,用来训练每位说话人的特征都留在原处。
- 优化器 AdamW,学习率 2.0×10⁻⁵,WSD 调度,1,000 步线性预热再加 15,000 步衰减到峰值的 15%。
dots.tts.edit V1.1 的 doteBench 有五类编辑
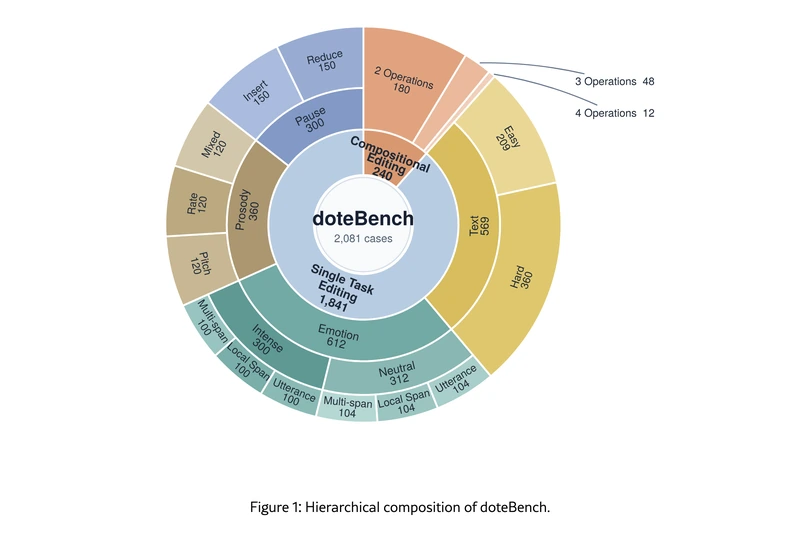 论文 Figure 1,doteBench 共 2,081 个用例,单任务 1,841 个、组合 240 个
- 基准共 2,081 个用例,中英双语,1,487 个来自真实录音、594 个来自合成语音。
- 五类分别是文本、情感、韵律、停顿、组合,前四类各测一种操作,组合类把两类到四类操作放进同一条素材。
- 每类都报三个维度:指令执行看要求改的地方有没有改对,局部保持看没被指定的区域内容、时长、音高、说话人是否原样,音频质量用 UTMOS 打分。
- 文本分 Easy 与 Hard 两档,Hard 的上下文更长、替换片段更大、且一条指令里含多处文本操作。
- 情感分 Neutral 与 Intense 两档,Neutral 用中性录音当源,Intense 用强情感合成音频当源,每档都覆盖整句、单段、双段三种作用范围。
- 韵律测音高与语速,音高请求是正负 4 个半音,语速请求是 0.8 倍与 1.25 倍,对应时长加 25% 与减 20%。
- 停顿测插入与缩短两个方向,主指标是方向准确率,同时报时长与音高的保持情况。
- 组合类的 240 条里,两操作 180 条、三操作 48 条、四操作 12 条。
- 录音来源是 LibriTTS-R、Common Voice 20.0、FLEURS、Multilingual LibriSpeech、AISHELL-3、AISHELL-1 的公开测试集。
dots.tts.edit V1.1 在四类单任务上的数字
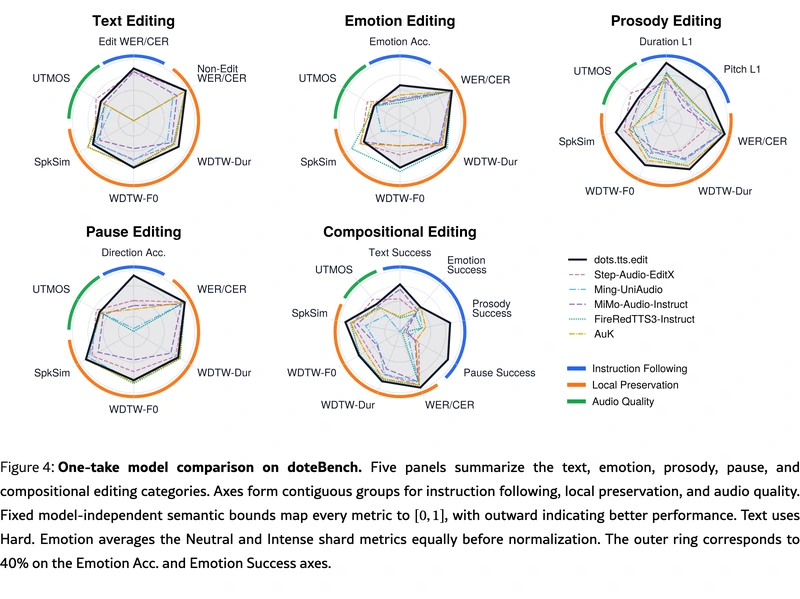 论文 Figure 4,五个面板对应文本、情感、韵律、停顿与组合,蓝橙绿三段分别是指令执行、局部保持、音频质量
| 项目 |
dots.tts.edit |
同表最高开源基线 |
| 文本 Hard 编辑区 WER/CER |
14.45% |
19.47%(Step-Audio-EditX) |
| 文本 Hard 未编辑区 WER/CER |
0.85% |
0.85%(与 Step-Audio-EditX 并列) |
| 情感 Neutral 准确率 |
37.98% |
27.40%(AuK) |
| 情感 Intense 准确率 |
8.50% |
6.25%(AuK) |
| 韵律 时长 L1 |
0.054 秒 |
0.201 秒(Ming-UniAudio) |
| 韵律 音高 L1 |
1.51 半音 |
3.75 半音(FireRedTTS3-Instruct) |
| 停顿 方向准确率 |
92.00% |
51.17%(Step-Audio-EditX) |
- 文本 Hard 那档,编辑区错误率 14.45%,比第二名低 5.02 个百分点;同表 AuK 是 103.67%、Ming-UniAudio 是 145.97%,这两家的错误率都超过 100%,输出的内容与目标文本对不上。
- Easy 档的编辑区错误率 1.74%,未编辑区 0.78%。
- 情感这一项整体偏低:Neutral 37.98%、Intense 8.50%,参与对比的系统没有一家在 Neutral 档超过四成、在 Intense 档超过一成。源音频本身带强情感、再换另一种强情感,是所有对比系统都没解决的问题。
- 韵律的两项误差是时长 0.054 秒、音高 1.51 半音,局部保持的 WDTW-Dur 是 6.00%、WDTW-F0 是 1.57 半音。
- 停顿方向准确率 92.00%,第二名 51.17%,相差 40.83 个百分点。
- 24 名双语志愿者做了听测,70 个案例、每例 4 人。指令遵循的平均偏好 1.538、局部保持 0.735、音频质量 0.598,前两项在参与对比的系统里最高,音频质量排第二,Step-Audio-EditX 的 1.010 更高。
dots.tts.edit V1.1 的组合编辑成功率是 42.92%
- 一次生成模式下一次调用完成整条指令,操作级成功 68.12%、整条全对 37.92%;同表最高开源基线是 MiMo-Audio-Instruct 的 31.70% 与 9.58%。
- 改成逐步执行,先做文本再做声音操作,每一步都拿上一步的输出当输入,整条全对的比例升到 42.92%,情感单项从 21.01% 升到 33.33%。
- 同表 AuK 逐步执行是 18.33%,Step-Audio-EditX 是 7.50%,FireRedTTS3-Instruct 是 9.17%。
- 一次生成的声音相似度是 0.908、UTMOS 3.37,逐步执行是 0.839 与 3.29。
- 操作级看,一次生成的停顿是 90.58%、韵律 83.33%,逐步执行是 88.41% 与 77.54%。
- 数据管线当基线时能到 72.10% 与 45.83%,它是每种操作单独用一套工具、把原波形其余部分保留下来拼出来的,属于工程路径,不是单模型。
- 文本 Hard 这类长替换上,模型与数据管线的编辑区错误率是 14.45% 对 24.87%。
dots.tts.edit V1.1 在 SpeechEditBench 上的三项最佳
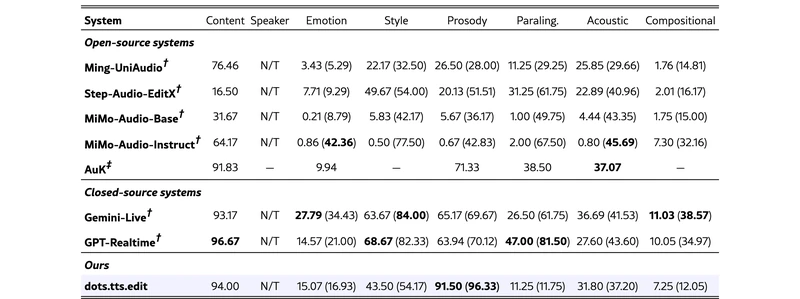 论文 Table 19,括号内是目标成功率,N/T 表示该接口不支持这一类,短横线表示未报告
- 这是第三方基准,联合成功率的口径与本家 doteBench 不同,只能横向看同一张表。
- 内容是 94.00%,开源系统里最高,AuK 是 91.83%;闭源的 GPT-Realtime 是 96.67%。
- 韵律是 91.50%,比同表所有开源与闭源系统都高,GPT-Realtime 是 63.94%、Gemini-Live 是 65.17%。
- 情感是 15.07%,开源里最高,但闭源的 Gemini-Live 有 27.79%、GPT-Realtime 有 14.57%。
- 风格这一项 V1.1 新增,得分 43.50%,低于 Gemini-Live 的 63.67% 与 GPT-Realtime 的 68.67%,也低于 Step-Audio-EditX 的 49.67%。
- 副语言 11.25%、声学 31.80%、组合 7.25%,组合这一项与 MiMo-Audio-Instruct 的 7.30% 相差 0.05 个百分点。
- 只评了 3,680 个请求,就是组件能映射到模型控制项的那些。说话人迁移、咳嗽笑声、音效插入不在覆盖范围,这些请求按失败计入分母。
dots.tts.edit V1.1 编辑后仍保留零样本 TTS
- Seed-TTS-Eval 三个分片的结果:英文 WER 1.26%、说话人相似度 0.764,中文 CER 0.97%、相似度 0.805,中文难集 CER 6.48%、相似度 0.794。
- 与基座 dots.tts 对比,三项是 1.34%/0.768、0.96%/0.805、6.46%/0.792,差在 0.08 个百分点与 0.004 以内。
- 同一张表里 Qwen3-TTS 1.7B 是 1.23%/0.717,VoxCPM2 2B 是 1.84%/0.753,编辑训练没有把语音克隆能力换掉。
- 两者共用一套参数,同一份权重既能改录音,也能拿一段参考音频合成新句子。
- 合成侧走 dots.tts 的命令行,编辑侧走 dots.tts.edit,编辑入口有自己的步数与引导系数。
dots.tts.edit V1.1 的本地安装与命令行
- 建 Python 3.10 到 3.12 的环境,执行
pip install dots.tts,或者克隆仓库后 pip install -e . -c constraints/recommended.txt。
- 准备源音频,命令行示例用的是 wav,放在本地路径下。
- 写指令串,把要改的字包进对应的标签,多个操作用多个标签并列。
- 执行命令行:
dots.tts.edit --model-name-or-path dots-studio/dots.tts.edit --source-audio input.wav --instruction 'Hello <sub targ="small">brave</sub> world.' --output edited.wav。
- 需要固定转录时补
--source-text 与 --target-text,两者都填会覆盖模型推导的结果。
- 采样步数用
--num-steps,默认 10,可调到 32;--guidance-scale 默认 1.2。
- 说话人引导默认 auto:指令里全是 emo、bg、enhance 时关闭,有文本、音高、语速、停顿、说话人迁移或混合编辑时打开。
- Python 侧用
DotsTtsEditRuntime,from_pretrained 加载同一份权重,generate_edit 收源音频路径、指令、步数与引导系数。
- 第一次运行会下载权重并缓存到本地,之后走缓存。
- 本地编辑台要 Node 20+ 先构建前端:
cd apps/edit_playground/frontend && npm ci && npm run build,再回仓库根目录跑 python apps/edit_playground/app.py --model-name-or-path dots-studio/dots.tts.edit --optimize。
- 编辑台自带的音频预设是空的,源音频要自己上传;本地转写需要装
.[edit_playground_asr] 并指定 --asr-model Qwen/Qwen3-ASR-1.7B。
dots.tts.edit V1.1 编辑台的预设与操作标签
- 网页版在 dots-studio-dots-tts-edit.hf.space,不需要装环境,打开就能用。
- 预设列表有十项,按语言和操作分:Text · English、Emotion · English、Pitch · Mandarin、Rate · Mandarin、Pause · English、Compositional · Mandarin、Noise preservation · English、Denoising · Mandarin、Multi-speaker · English + Mandarin,还有一项 First Glance · Mandarin + English。
- 选中转录里的文字后弹出操作菜单,可选 Pause、Replace、Rate、Emotion 四类,Pause 与 Emotion 要选等级,Rate 填倍率,Replace 填替换文本。
- 所有已加的操作排在编辑源下方,带序号与删除按钮,末尾显示总条数与 Apply Edit。
- 示例素材上叠了 6 个操作:插入停顿、三处替换、0.67 倍语速、生气,一次提交一起生效。
- 右上有 Model 下拉,可以切 checkpoint;页面顶部同时放着 Demo、arXiv、Checkpoint、GitHub、Benchmark、Data Pipeline 六个入口。
- 编辑台有 Preview 开关,打开后可以先试听,再点 Apply Edit 提交。
- 试听案例在 dots-studio-dots-tts-edit-demo.static.hf.space,只放音频不放开编辑。
dots.tts.edit V1.1 没有覆盖的编辑类型
- 论文的局限段写明只研究了四类控制,说话人转换、声学场景编辑、方言与口音转换要另配成对数据与评测才能扩。
- SpeechEditBench 的组合项只有 7.25%,原因是很多请求里含模型不支持的操作,这些请求没有从分母里剔掉。
- Intense 档的源音频本身就是强情感合成语音,再换成另一种强情感时准确率只有 8.50%。
- 情感项支持 8 类固定类别,也可以加描述条件;风格项是自由形式的描述输入,改动幅度由描述文字决定,风格一项在 SpeechEditBench 上的得分是 43.50%。
- README 的风险段写明克隆滥用问题,建议下游配 语音深度伪造检测、参考音频授权策略与内容水印,并标注 AI 生成音频。
- 训练语料以语音为主,唱歌与语音加音效的统一生成不在这一版范围。
- 阿拉伯语、印地语、土耳其语、越南语这类文字体系差异大的语言,错误率高于中英,说话人相似度不受影响。