
即夢的短劇聲音由畫面模型在同一次生成裡一併輸出,不用另外配音。前提是模型欄選2.0 以上檔位,並且台詞按角色名加冒號再引號的格式寫進提示詞;選到 1.0 那一檔只出無聲畫面。
即夢的影片模型分兩代,2.0 以上的檔位在生成畫面的同一次任務裡把音軌一併輸出。模型內部是兩條分支,一條出畫面幀,一條出音訊波形,靠對齊機制把口型壓在語音上。流程裡沒有先出無聲片再配音這一步,成片匯出時已經帶聲音,對白、環境音和背景音樂都在這一條音軌裡。
1.0 那一檔是純畫面模型,輸出沒有音軌。同一段劇本、同一段提示詞,有人出來的片子有對白,有人出來是啞的,差別就在模型檔位。
創作設定面板的影片欄裡,模型下拉一共六項,出聲與否按檔位分:
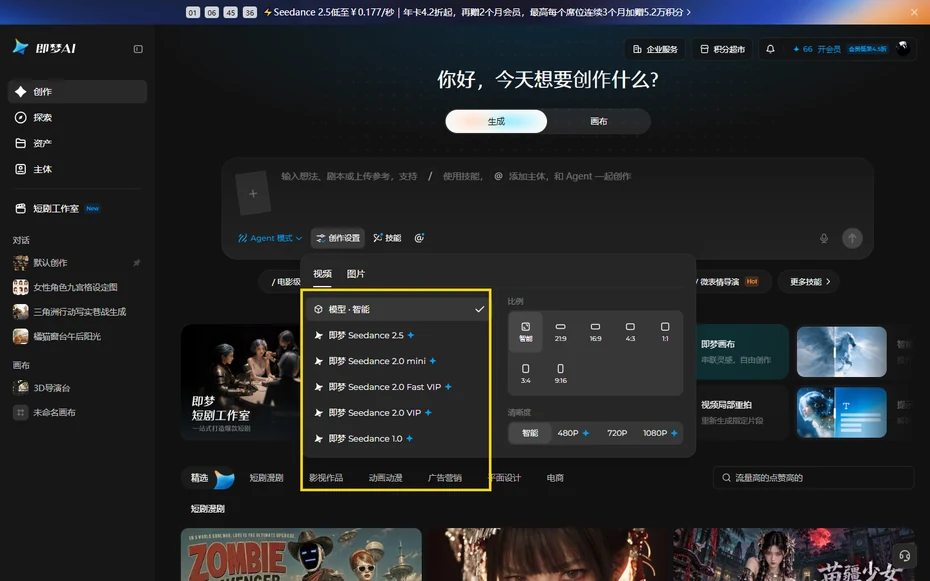
不帶 VIP 標記的四項免費帳號就能選,帶 VIP 的兩檔要開會員才亮起來。做短劇時想先看構圖,用 1.0 省積分可以,但別拿它驗收聲音,它本來就不出聲。
模型不會自己判斷哪句話是誰說的,得在提示詞裡標出來。寫法是角色名在前,跟一句動作或表情,冒號後面用引號包住台詞原文,多角色一人一行。
1. 先寫角色名和這一鏡的動作,例如女主低頭哽咽
2. 冒號後直接用引號寫台詞原文,不加他說她說這類轉述
3. 第二個人物另起一行,格式與前一行相同
兩個人物同框卻不標說話人,模型容易把台詞分給錯的人,或者乾脆不開口。台詞前後加上語氣和語速的描述,念出來的節奏會更貼畫面,例如緩慢說、壓低聲音說。這種寫法和即夢對口型功能的用法不是一回事,那條路是拿現成音訊去貼畫面,這裡是讓模型自己念。
一個鏡頭塞一整段對白,後半句的口型就跟不上了。規則是一句話一個鏡頭,長台詞拆成兩個鏡頭接。按即夢提示詞指南的口徑,10 秒鏡頭配 20 字台詞是上限,超過就得拆。
拆的時候保留動作連貫,前一個鏡頭說完半句停在表情上,下一個鏡頭從回應動作接。台詞裡帶停頓的位置也寫出來,模型才知道哪裡該停。
同一部短劇裡,同一個角色跨集保持音色,靠兩件事。一是每一集的提示詞裡重複同一句音色描述,措辭一個字不改,例如低沉偏沙啞的男聲、語速偏慢;二是把上一集裡這個角色的聲音片段當參考素材帶上,2.0 檔位支援音訊參考輸入。
角色名也要統一。第一集叫阿哲,第三集改成男主,模型會當成另一個人處理。角色形象和聲音綁在同一套描述上,描述一變,兩條線一起漂,所以鎖角色特徵和鎖音色要用同一句描述。
寫清楚才帶。即夢合成的聲音分對白、環境音和配樂三部分,但配樂不是自動鋪滿全片,得在提示詞裡點明要什麼樂器、什麼節奏、從哪一鏡進、音量壓到什麼程度。不寫的話出來只有對白和現場環境聲,配樂要自己後期加,加的時候還要避開人物說話的段落。
能。成片匯出後在剪輯軟體裡把原音軌分離,換成自己錄的對白或別的音色。不過原片的口型是按模型自己唸的那版台詞生成的,換人重配之後發音節奏變了,口型對不上,時間軸要重新調。角色多、台詞密的話,換配的工作量比重新生成一條還大。
能,把口音要求直接寫進提示詞就行,例如四川話、東北話、粵語。即夢的音畫同步支援多種方言的口型和發音,標了之後模型按方言的發聲習慣合成語音,嘴型也跟著變。不標的話按普通話念,台詞裡夾著的方言詞會念得很彆扭,得逐句改回書面語。
寫在人物台詞之外單獨一行,先標明這是旁白,再把要唸的整段文字給全。旁白沒有對應的人物口型,模型會當畫外音處理,畫面裡不用出現說話的人。旁白和台詞混在一行寫,模型容易把旁白當成某個角色說的話,還會照著這段話給它配上口型。
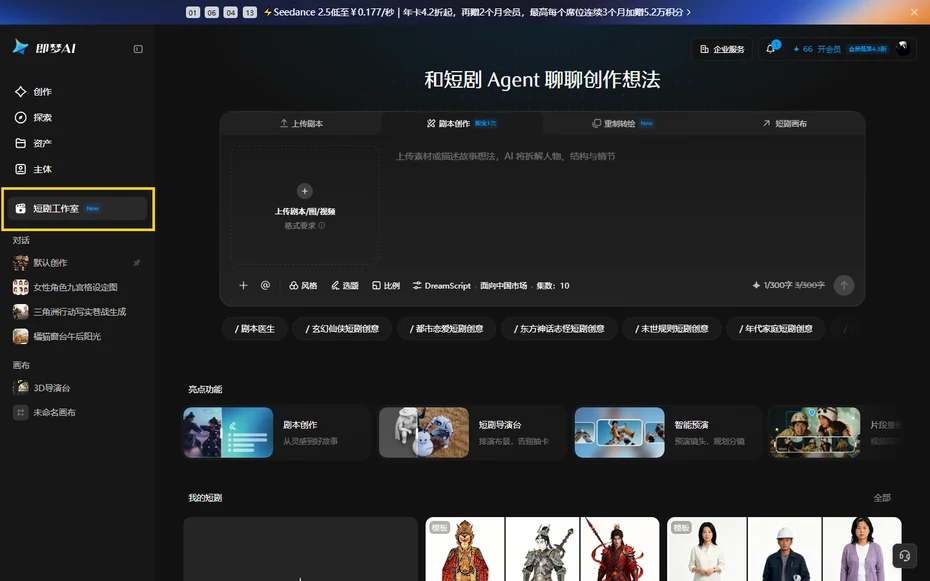
即夢的短劇工作室不是另一個影片生成頁,它從劇本開始拆人物、情節和分鏡,再把鏡頭串成劇集。入口在左側導航,進去是四個頁...
2026-10-27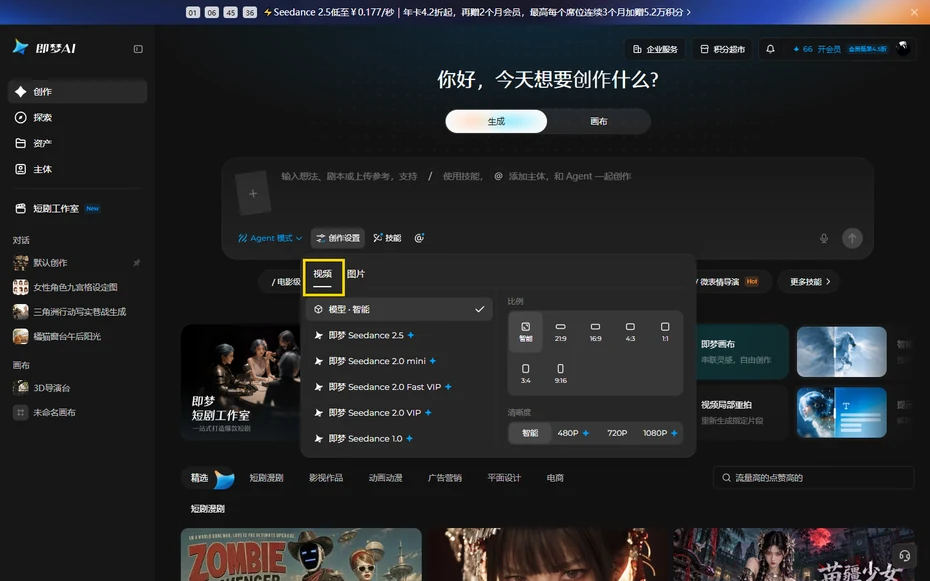
即夢沒有單獨的防抖開關,能動的只有創作設定裡的模型檔位和清晰度,其餘靠提示詞和區域性重拍。模型欄 5 檔、清晰度 4 檔,先...
2026-10-27
即夢短劇工作室是一款專業的短劇創作和管理平台,主要用來創作、上傳和管理短劇內容。使用者可以編寫劇本、上傳影片素材、設定...
2026-10-27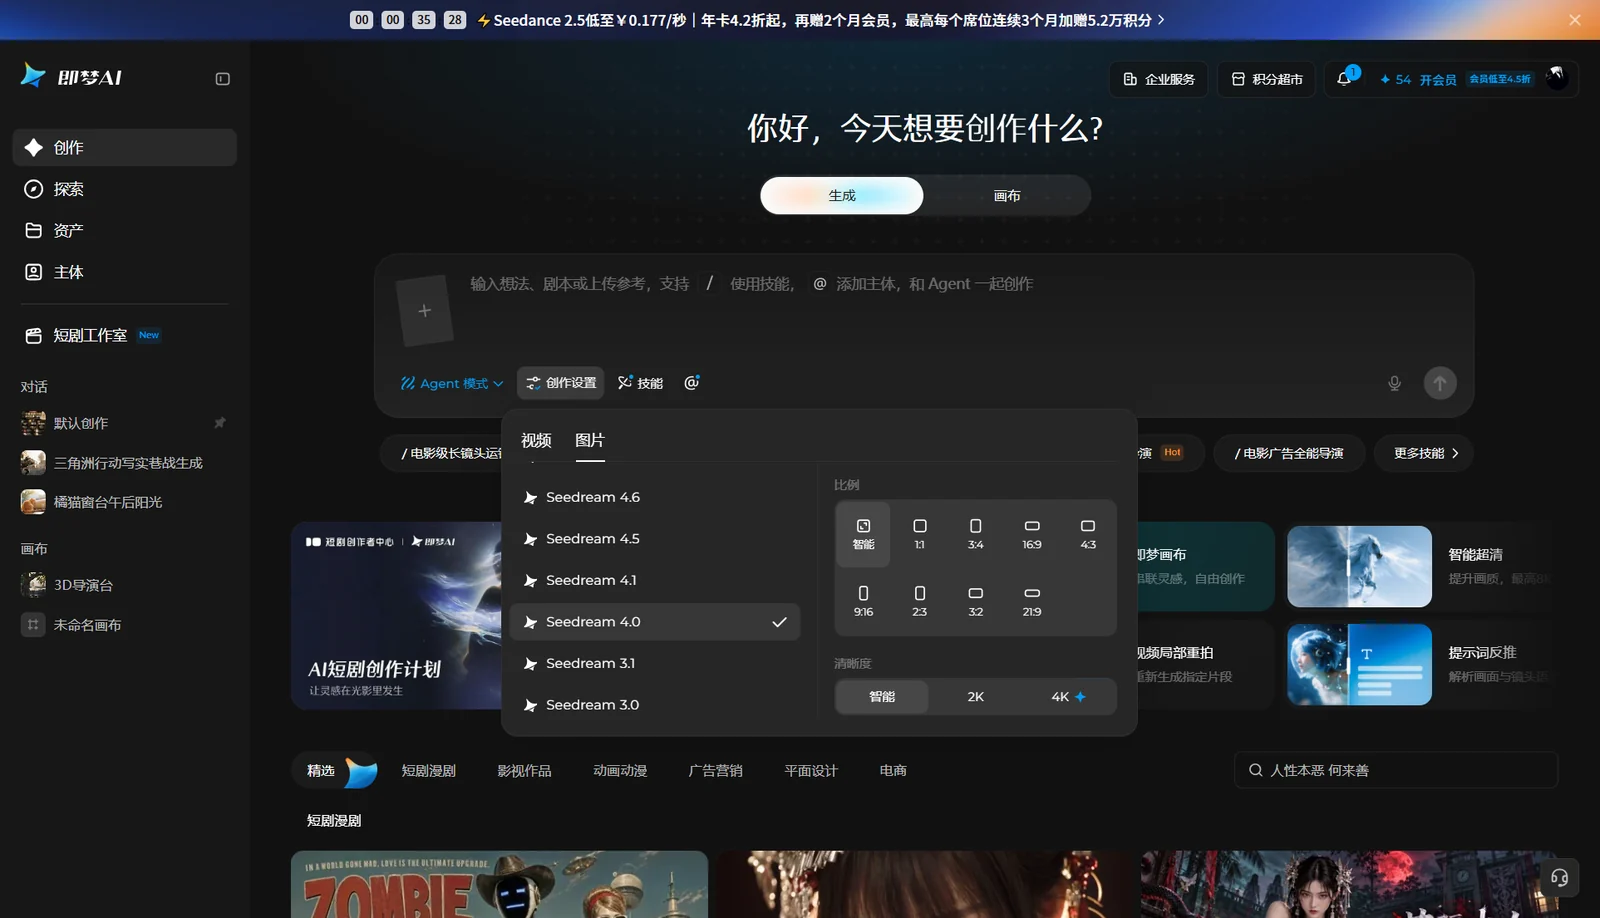
即夢的圖片模型現在一共 9 個檔位,圖片 4.0(Seedream 4.0)是其中偏下的一檔,不是最新。要用它出圖,動作只有一個:在「...
2026-10-27
即夢AI可以生成三維圖。它的圖生3D和文生3D功能能讓你用文字提示或參考圖片快速生成立體模型和三維圖像。但需要澄清一點:即...
2026-10-27