
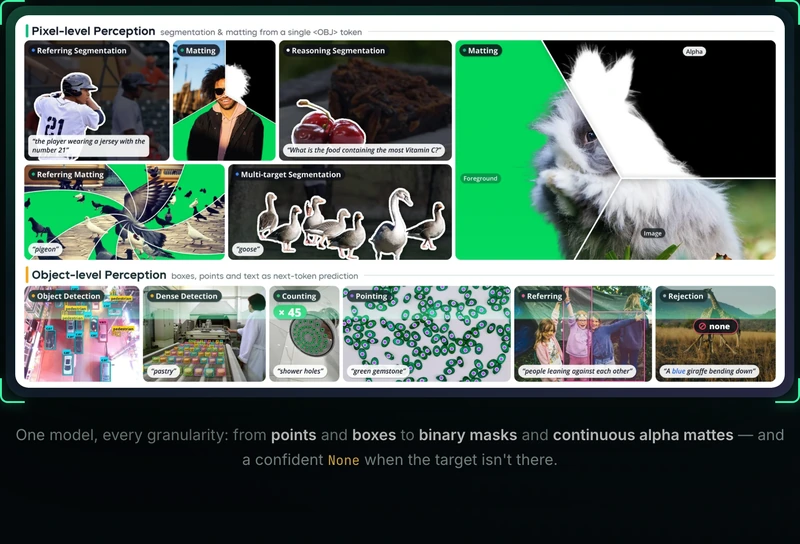
WeVisOne-VL 是騰訊微信視覺團隊 2026 年 10 月 23 日開源的視覺語言模型,2B 和 4B 兩檔,程式碼 Apache-2.0,基座是 Qwen3-VL。它把目標檢測、指代定位、計數、點標註、OCR、指代分割和提示式摳圖放進一個模型,輸出可以是點、框、二值掩碼或 alpha 蒙版,目標不存在時返回 None。項目頁在 tencent.github.io/WeVisOne-VL,權重在 Hugging Face 的 tencent/WeVisOne-VL-4B 和 tencent/WeVisOne-VL-2B。
名字拆開是 WeChat Vision All-in-One。它做細粒度視覺感知,不做開放式對話:給一張圖和一句查詢,返回查詢目標的位置或者畫素。
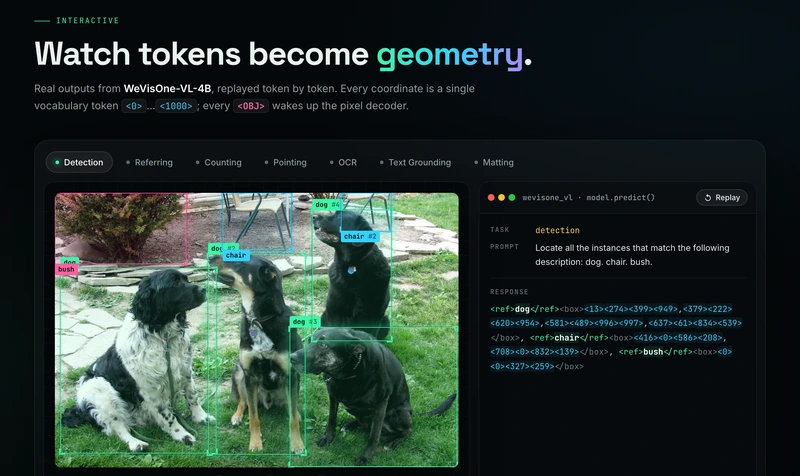
位置用座標 token 表示。<0> 到 <1000> 共 1,001 個專用 token 編碼歸一化座標,一個框佔 4 個 token,一個點佔 2 個。
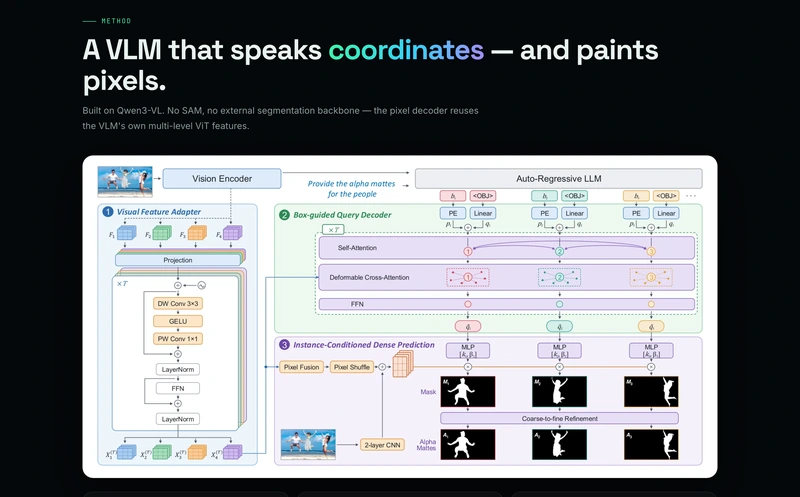
畫素結果由 9.6M 參數的解碼器出,掛在語言模型吐出的 <OBJ> token 後面。解碼器不接第二個圖像編碼器,直接取 Qwen3-VL ViT 的四層 pre-merge 特徵,所以分割和摳圖不用外掛 SAM。解碼器內部分三段:視覺特徵適配器做投影、6 個 deformable cross-attention 用 <OBJ> 隱狀態和框當 query、稠密頭按 S/4 到 S/2 到 S/1 逐級細化成全解析度掩碼。
task 參數有九個取值,query 按任務填類別列表或自然語言描述:
| task | query 填什麼 | 輸出 |
|---|---|---|
| detection | 類別列表 | 每個實例的框 |
| referring | 自然語言描述 | 框,或 None |
| point | 類別 / 描述 | 座標點 |
| count_box | 類別 / 描述 | 框,加數量 |
| count_point | 類別 / 描述 | 點,加數量 |
| ocr | 空 | 文字和文字框 |
| ocr_grounding | 要查詢的文字 | 文字和文字框 |
| segmentation | 類別 / 描述 | 框加二值掩碼 |
| matting | 類別 / 描述 | 框加 alpha 蒙版 |
只做文件轉 Markdown 或 JSON 的時候,Xiaomi-OCR-0 那類文件解析模型更對口,它出的是結構化文字,不是框和掩碼。
git clone https://github.com/Tencent/WeVisOne-VL.git
cd WeVisOne-VL
conda create -n wevisone-vl python=3.10 -y
conda activate wevisone-vl
pip install -r requirements.txt
pip install -v -e .from wevisone_vl import WeVisOneVL
model = WeVisOneVL(
"tencent/WeVisOne-VL-4B",
backend="transformers",
)result = model.predict(
image,
task="detection",
query=["sofa", "pillow"],
)
result = model.predict(
image, task="matting", query="person"
)
CUDA_VISIBLE_DEVICES=0 python demo/app.py \
--model tencent/WeVisOne-VL-4B4B 版本在官方表裡的九項關鍵指標,對比列是各榜開源基線裡的最好成績:
| 任務 | 基準 | 指標 | 基線最好成績 | 4B |
|---|---|---|---|---|
| 目標檢測 | LVIS | 平均 F1 | 50.7 | 55.3 |
| 密集檢測 | Dense200 | 平均 F1 | 58.7 | 71.3 |
| 指代檢測 | RefCOCOg test | 平均 F1 | 77.6 | 81.8 |
| 目標計數 | PixMo-Count test | 準確率 | 82.8 | 89.6 |
| 點標註 | PointBench | 準確率 | 69.9 | 71.9 |
| OCR | TotalText | 平均 F1 | 43.3 | 52.0 |
| 指代分割 | ReasonSeg val | gIoU | 65.0 | 71.2 |
| 框提示摳圖 | P3M-500-NP | MAD 越低越好 | 15.4 | 7.3 |
| 文字提示摳圖 | WeRefMat | MAD 越低越好 | 22.4 | 9.8 |
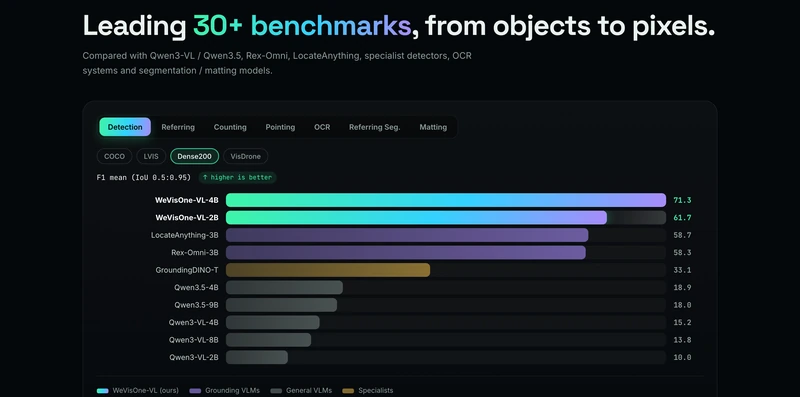
檢測、指代、OCR 的 F1 按 IoU 0.5 到 0.95 取平均,貪心解碼。這些數字都出自騰訊自己的評測表,目前沒有第三方復現。
兩個權重在 Hugging Face 上標的是 2.44B 和 4.83B 參數。官方單獨給了 2B 在 Dense200 的分數,61.7,比 4B 低 9.6 個點。摳圖反過來:P3M-500-NP 的 MAD 2B 是 6.6,4B 是 7.3,這項越低越好。要跑密集檢測、OCR、指代定位取 4B;只做摳圖和主體分割,2B 更小也更準。
資料來自一條知識圖譜驅動的標註管線:SAM3、Rex-Omni 和自研檢測器提候選區域,Qwen3-VL 覈驗,覈驗過的框再擴成掩碼和 alpha 蒙版,累計 1 億張以上圖像。把掩碼轉成透明蒙版的標註器按 mask2alpha 分支單獨開源。
訓練是三段 SFT 接一段強化學習:
| 階段 | 樣本量 | 做的事 |
|---|---|---|
| SFT 第 1 段 | 9,020 萬 | 對齊輸出格式 |
| SFT 第 2 段 | 4,050 萬 | 提到 1,960 個視覺 token,單次最多 500 個框 |
| SFT 第 3 段 | 4,180 萬 | 訓畫素解碼器,之後在 1.3 億樣本上專訓摳圖 |
| GRPO | 17.8 萬 | 混合任務強化學習,按不確定度篩樣本 |
訓練上下文 8,192 token。報告裡沒給部署時的上下文上限,也沒給顯存佔用。
倉庫首次公開提交在 2026 年 10 月 23 日,README 在 10 月 25 日更新過一版。
Piccolo 是阿里 AgentScope 團隊 2026 年 10 月 30 日開源的決策模型,分 27B、9B、4B 三檔,Apache-2.0。輸入是當前狀態、一...
2026-11-05
Kimi Hosted Agents 是月之暗面 2026 年 11 月 5 日上線的雲端 AI Agent 託管服務。Agent 運行所需的會話、沙箱、工具調用、...
2026-11-05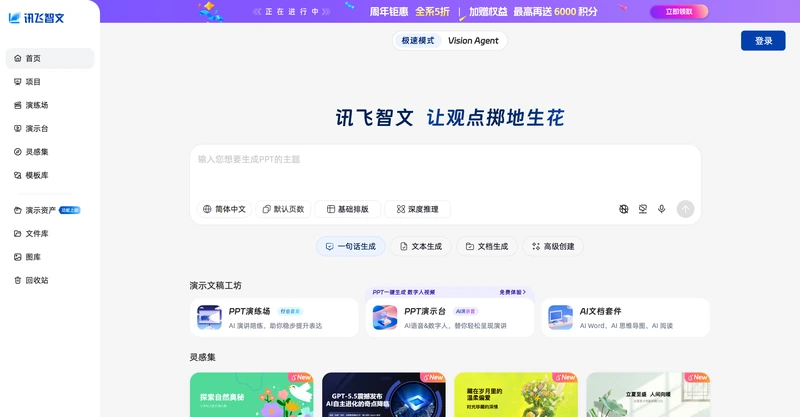
訊飛智文的工作台頂部並排兩個頁籤,極速模式按一句佈景主題直接出稿,Vision Agent 按一段要求先定結構再出稿。做一份拿得出手的...
2026-11-05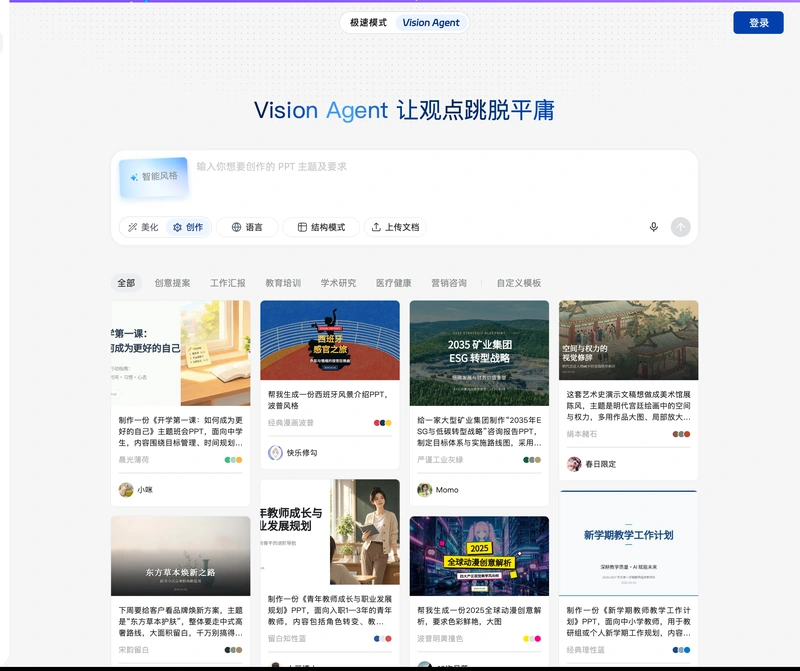
訊飛智文的網頁版在 zhiwen.xfyun.cn,瀏覽器打開首頁,右上角點登入用微信掃碼,回首頁在輸入框寫佈景主題,頂部選極速模式或 Vi...
2026-11-05
Looogen(中文名邏輯智片)是阿里推出的 AI 影視創作工作台,口號“有邏輯,自成片”,只發桌面客戶端,創作會話、素材和成片都...
2026-11-05