
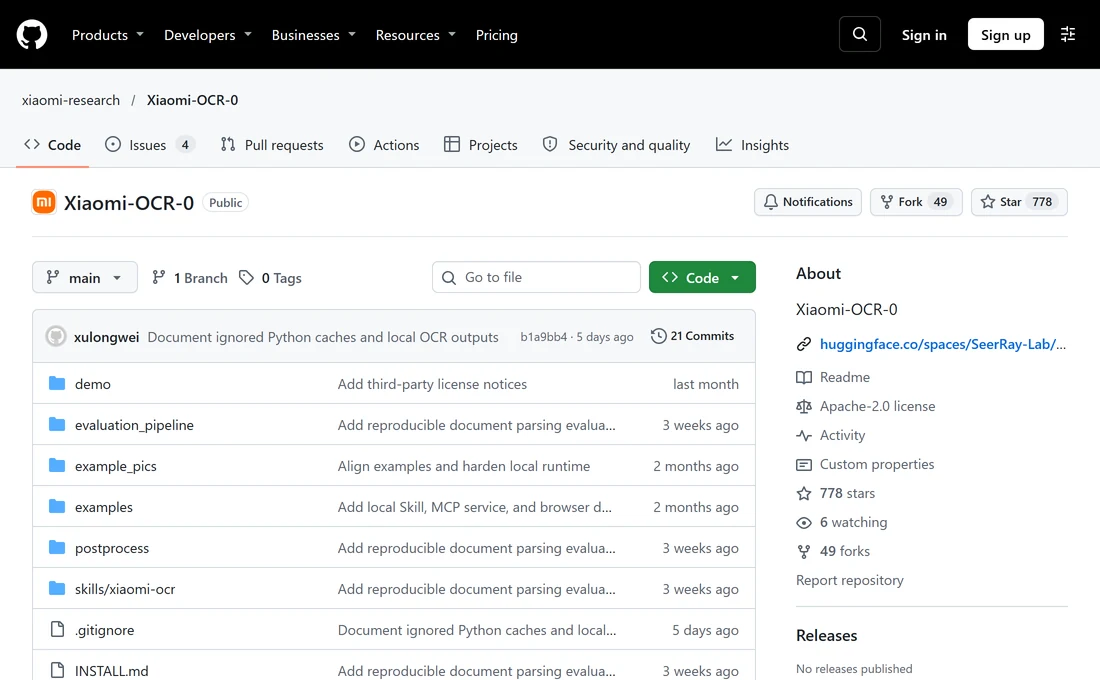
Xiaomi-OCR-0 是小米在 2026 年 9 月 30 日開源的0.8B 文件解析模型,一套權重同時幹三件事:把整頁文件讀成結構化 Markdown、按指定欄位抽 JSON、回答頁面上數字之間的問題。表格它出 OTSL 再由後處理轉成 HTML 塞進 Markdown,公式直接落成 LaTeX,都是能改的程式碼,不是截圖裡的死字。
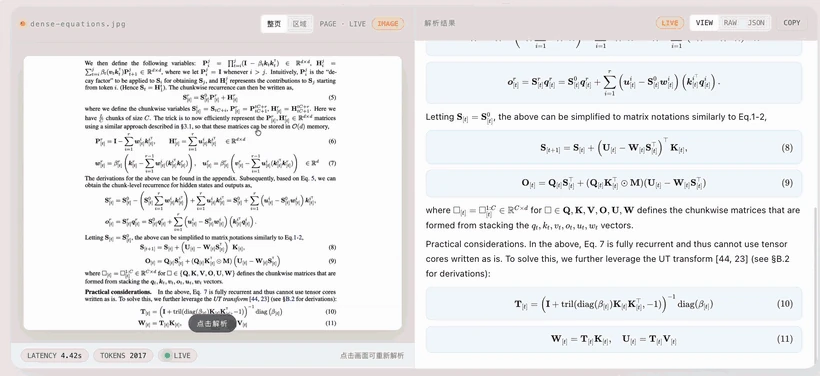
常規 OCR 把字認出來排成一行行文字;它按自然閱讀順序還原版面,標題、正文、表格、公式各歸其位,後兩者還是可編輯程式碼。
時間線有個錯位:論文 9 月 28 日提交,權重 9 月 30 日已放,小米 10 月 30 日才對外宣佈。
三件活輸出三種東西,靠同一套指令切換,不用為解析、抽取、問答各裝一個模型。
同一份權重給了兩種跑法,README 直接寫了取捨,選錯會掉精度。
區域依賴在純 CPU 上也能跑,把 XIAOMI_OCR_LAYOUT_DEVICE 設成 cpu 即可,副作用是排版分析變慢。
三個解析榜的分數都用兩階段法跑出來:先版面模型,再逐塊推理。
| 榜單 | Xiaomi-OCR-0 | 第一是誰 |
|---|---|---|
| Real5-OmniDocBench | 95.24 | 本模型 |
| OmniDocBench v1.6 | 96.83 | TeleOCR 96.87 |
| Wild-OmniDocBench | 87.94 | TeleOCR 88.53 |
表格沒領先:PubTabNet 的 TEDS 是 92.27,TeleOCR 給到 97.05,差近 5 分。公式 UniMER-Test 97.84。古籍書法綜合 73 分,閉源 Seed 2.0 Pro 是 72。
兩條路:自己按文件裝,或把一句話交給 Agent。後者會建環境、下權重、註冊 MCP,動的是你本機,README 專門加了警告。
1.備齊 Python 3.10 以上,顯卡按 SGLang 或 vLLM 支援的列表挑一張。
2.起推理服務,上下文長度按官方的 16384 設,架構名認 Qwen3_5ForConditionalGeneration。
3.跑 demo/server.py,埠 8787,整頁、區域、抽取、問答共用同一個頁面。
4.不想碰顯卡就走 Ollama,社區 BF16 包約 1.8 GB,精度只做過有限驗證。

Loomy AI是一款裝在電腦上的AI辦公智慧體,主要就是幫你快速生成PPT、寫文件、做表格和管理郵件。最大的特點是完全免費,每...
2026-11-03
千問陪逛是千問 App 裡的購物助手,開著螢幕共享逛淘寶,AI 一邊看螢幕一邊回答。它會提煉商品參數、成分表和評價裡的坑,你...
2026-11-03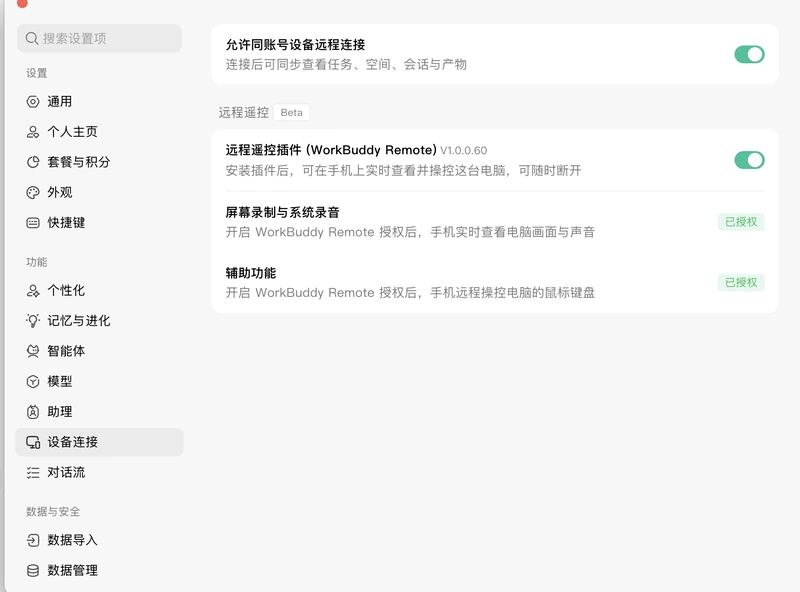
WorkBuddy遠程控制讓手機接管電腦桌面,手指點哪裡就等於點電腦的同一位置。簡單的事在手機上打一句話就行,電腦端接著跑,只...
2026-11-03
PixTV 的片段重拍不在頂部菜單,藏在影片節點懸停後彈出的圖標條裡。框住要改的那幾秒,再寫清這一段要變成什麼,生成的就是...
2026-11-03
updream充的限時積分是先用的嗎?不按“限時”兩個字判斷,按到期時間判斷:儲值加贈的那部分帶有效期,到期清零;自己付錢買的...
2026-11-03