
文心5.5 Flash Base 是百度 2026 年 11 月 5 日開源的稀疏 MoE 語言模型,總參數 2800 億、每 token 啟用 140 億,只開放預訓練終點的權重,沒做中訓練和後訓練,可用於領域適配、指令微調與強化學習。權重在 Hugging Face 的 baidu/ERNIE-5.5-Flash-Base,FP8 與 BF16 兩版,說明頁在 ernie.baidu.com/release/ernie-5-5-flash-base。
它是文心這一代的開源基座,用於下游訓練。同代的對話產品是文心一言,這一版去掉對話能力,只留預訓練出來的底座。
| 項目 | 數值 |
|---|---|
| Transformer 層數 | 43 |
| hidden size | 4096 |
| 注意力頭 | 64 |
| MoE 層專家 | 512 個路由專家 + 1 個共享專家,每次啟用 10 個 |
| 專家隱空間維度 | 2048 |
| 詞表 | 20 萬 |
| 預訓練 token | 33.5T |
43 層裡第一層的 FFN 是稠密塊,其餘各層是 MoE 塊。每個 MoE 層先把 token 從 4096 維投到 2048 維隱空間,專家在裡面計算,再由一次共享上投影投回原維度,dispatch 與 combine 的通訊量、專家 FLOPs 各減一半。
上下文長度按階段分開:預訓練最長 128K,微調和推理到 1M。
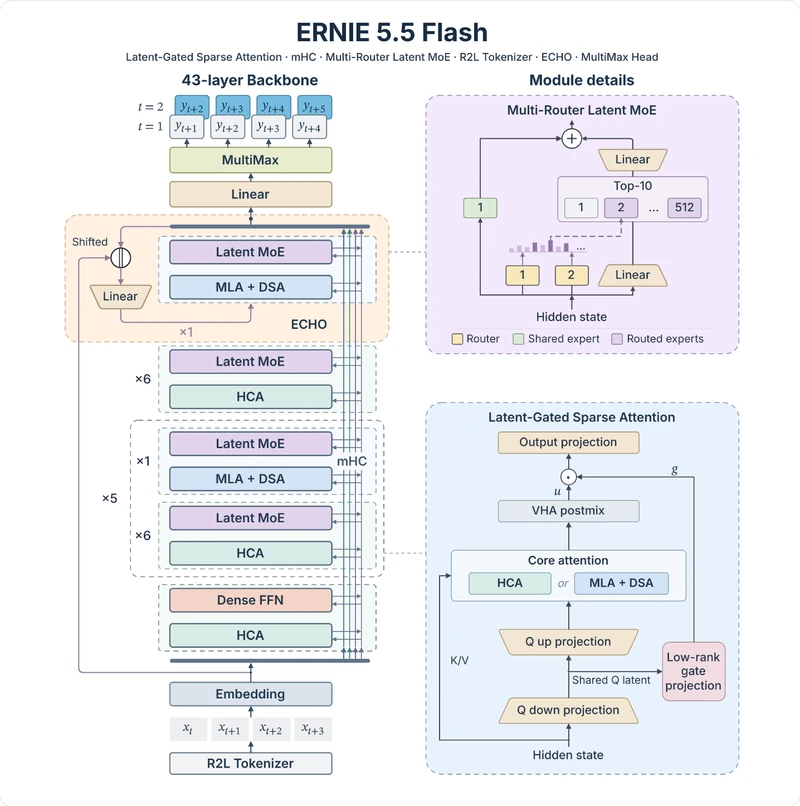
注意力層裡只有 6 層保留全上下文訪問,其餘 37 層在壓縮後的序列上算。
頭維度隨層類型不同:HCA 層在 128 倍壓縮後的序列上算,用 512 維頭;MLA 層逐 token 算,query/key 與 value 用 256 維頭。KV cache 預算集中給 6 層 MLA,不給先壓 4 倍再稀疏選位置的 CSA 層,官方在同等預算的預訓練對比裡測出 HCA 配 MLA 的分數高於配 CSA。
注意力內部另有兩處改動。低秩門控把輸出門的輸入換成注意力層自己生成的低秩 query latent,維度只有隱狀態的四分之一,門投影參數量減 75%。VHA 在注意力之後做一次帶恆等跳連的跨頭低秩混合,推理時並進運算元。
單路由器在中深層的問題:打分和專家實際效用弱相關,落選的專家拿不到梯度。這一版換成 Multi-Router,多個獨立初始化的 sigmoid 路由器一起打分,各路由器的偏好分化,一個專家被一個路由器打高分、或被幾個同時打高分,都能入選。啟用專家數、專家 FLOPs 和通訊量不變。
殘差連接換成 mHC,每層用受約束的混合矩陣讀寫 4 條並行殘差流。輸出頭換成 MultiMax,用分段可學習溫度,壓掉不合理 token 的長尾,保留合理候選,logits 在 Triton 融合的交叉熵 kernel 裡、softmax 之前調製。
多 token 預測原本要在主幹上掛一個專用模塊,多步損失只監督那個模塊。ECHO 改成複用主幹最後一層:讓主幹自己預測後續 token,多步損失直接打在生成下一個 token 的參數上。
官方只訓一步 ECHO。這一層能當投機解碼的草稿模型,同樣訓一步,多步起草的品質高於外掛 MTP。
分詞器同時更換:數字按從右到左、最多三位一組切,1,234,567 切成 1 / 234 / 567,位數對齊,算術和數字密集的文字切出的 token 數變少。
訓練側改了兩處,分佈式 Muon 最佳化器和 FlashMask-4 注意力運算元。
對比對象是發佈時同規模的開源 Base:DeepSeek 的 V4 Flash Base(284B-A13B)、Hy3-preview-Base(295B-A21B)、MiMo-V2.5-Base(310B-A15B)。四家用各自公開的 checkpoint,同一套評測框架、同一批 prompt 與 few-shot 樣例,問答題用同一個裁判模型。
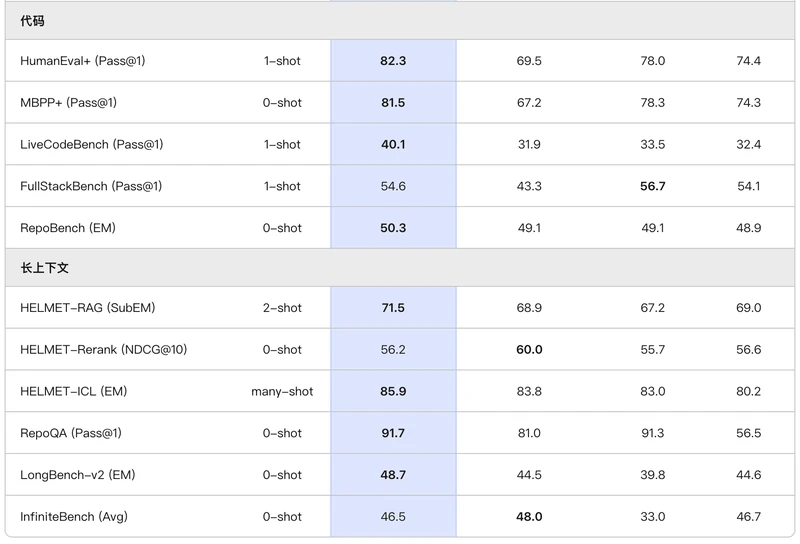
下表四列依次是文心5.5 Flash Base、DeepSeek V4 Flash Base、Hy3-preview-Base、MiMo-V2.5-Base,參數之後按綜合、知識、理科、推理、多語言、程式碼、長上下文各取一項。
| 項目 | 文心5.5 | DeepSeek V4 | Hy3 preview | MiMo V2.5 |
|---|---|---|---|---|
| 總參數 | 280B | 284B | 295B | 310B |
| 啟用參數 | 14B | 13B | 21B | 15B |
| MMLU | 93.3 | 89.4 | 87.5 | 87.6 |
| MMLU-Pro | 78.4 | 69.2 | 66.9 | 65.7 |
| CMMLU | 90.0 | 89.7 | 89.3 | 87.7 |
| PopQA | 52.2 | 48.7 | 49.3 | 45.7 |
| GPQA | 60.2 | 55.9 | 50.2 | 51.4 |
| BBH direct | 77.1 | 69.0 | 67.5 | 68.0 |
| MMMLU-lite | 81.0 | 78.5 | 76.1 | 72.2 |
| HumanEval+ | 82.3 | 69.5 | 78.0 | 74.4 |
| LiveCodeBench | 40.1 | 31.9 | 33.5 | 32.4 |
| HELMET-RAG | 71.5 | 68.9 | 67.2 | 69.0 |
30 項裡 24 項高於對比模型,綜合、理科、推理、程式碼四塊分數都在四家裡最高,差距最大的是 MMLU-Pro,比第二名高 9.2 分。
低於對比模型的 6 項:ChineseSimpleQA 73.0,DeepSeek 75.3;INCLUDE-lite 79.5 對 79.8;BBH CoT 89.2,Hy3 90.0;FullStackBench 54.6,56.7;HELMET-Rerank 56.2,60.0;InfiniteBench 46.5,48.0。
兩個倉庫都在 Hugging Face。模型卡標 286B 參數、F32 與 BF16 與 F8_E4M3 三種張量類型,許可為 ERNIE 5.5 Flash Base Model License Agreement v1.0。
Seko 的口型不靠畫面提示詞對,靠分鏡裡的台詞文字和這一句的配音音軌。台詞寫在畫面描述裡出來的只會是亂張嘴,要寫在分鏡的...
2026-11-08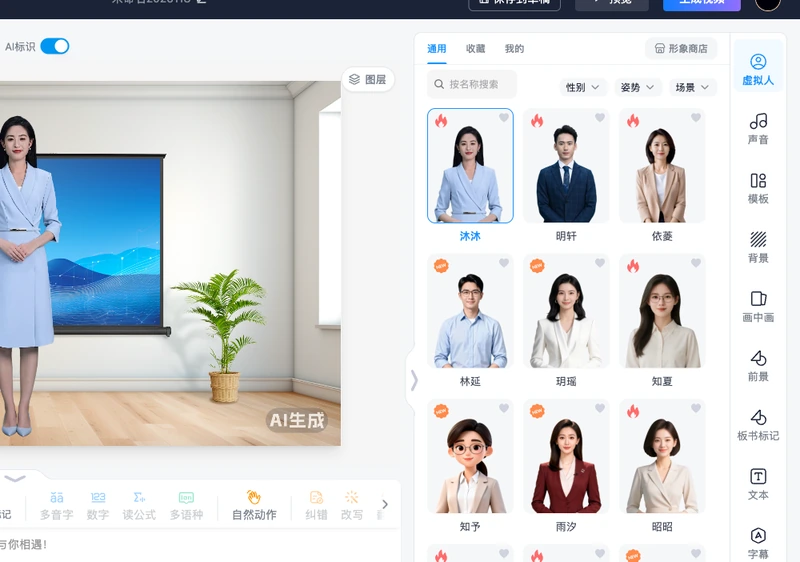
一個影片工程裡只掛一個數字人形象,右側圖層欄的“虛擬人”那一層只有一個位置,形象從旁邊面板裡挑一個。兩個數字人同框的做...
2026-11-08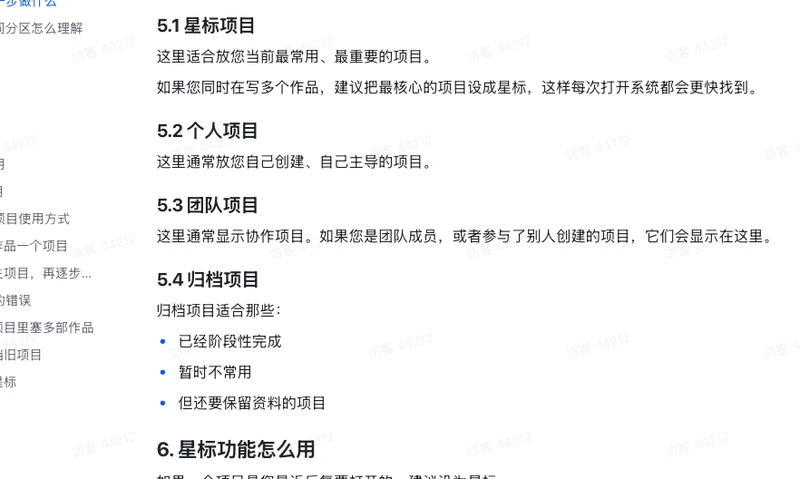
劇雲沒有自己申請加入團隊的入口。“團隊項目”那一欄裝的是別人創建、把你加進去的項目。要進團隊項目,只有一條路:項目創建...
2026-11-08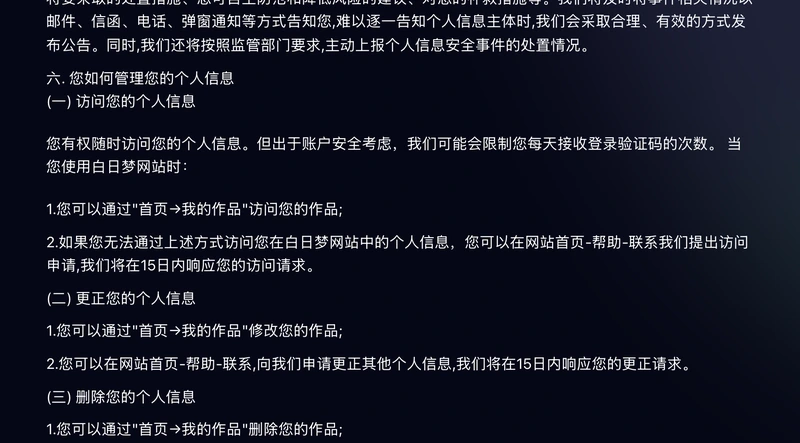
白日夢AI 的首頁沒有自助註銷按鈕,註銷走“幫助—聯繫我們”提交申請,隱私政策寫明收到申請後處理。順序是先關自動續費,再申...
2026-11-08
二狗PPT 的報錯按階段分三類:上傳階段、生成階段、匯出階段。狗糧按任務實際跑到哪一步結算,停在提交前的報錯不產生消耗,...
2026-11-08