
Claude Fable 5.2 是 Anthropic 2026 年 11 月 9 日發佈的模型,和 Claude Mythos 5.2 共用一套權重,差別在安全分類器:Fable 對所有人開放,Mythos 只給通過網路安全和生命科學驗證計劃的組織。上下文 100 萬 token,單次輸出上限 12.8 萬 token,模型 ID 是 claude-fable-5-2,Claude 應用、Claude Code 和三家雲平台當天都能選到。
Fable 帶網路安全和生物學分類器,遇到滲透測試、漏洞利用生成、二進制漏洞分析、研究級生物學任務會攔下來,攔下時由 Opus 4.8 或 Opus 5 接管回答。Mythos 拆掉這兩類護欄,只通過 Cyber Verification Program 和 Life Sciences Verification Program 發給審覈過的機構。
發佈頁給的用法是分級:日常程式設計和知識任務先用 Opus 5.5,做不動再切到 Fable 或 Mythos;簡單任務降到 Sonnet 5.5 或 Haiku 5.5。Fable 5.2 還能當 Advisor,接住 Haiku、Sonnet、Opus 交來的難題;也能當 Orchestrator,把簡單步驟派給更小的模型。
| 項目 | 數值 |
|---|---|
| 模型 ID | claude-fable-5-2,Mythos 是 claude-mythos-5-2 |
| 上下文 | 100 萬 token |
| 單次輸出上限 | 12.8 萬 token |
| 知識截止 | 2026 年 6 月 |
| 思考模式 | adaptive thinking 常開,深度只用 effort 調 |
| 輸入輸出 | 文字、圖片、PDF 進,文字出 |
| 輸入價格 | 每百萬 token 8 美元 |
| 輸出價格 | 每百萬 token 40 美元 |
| 快取讀 | 每百萬 token 0.2 美元 |
| 快取寫 | 5 分鐘 10 美元,1 小時 16 美元 |
| 批次介面 | 輸入輸出各半價,4 美元和 20 美元 |
| fast mode | 輸入 16 美元,輸出 80 美元 |
| 可用平台 | Claude 應用、Claude Code、Claude API、AWS、Google Cloud、Azure、Microsoft Foundry |
| 退役 | 不早於 2027 年 11 月 9 日 |
上下文長度和 Opus 5.5 同檔。價格每一行都比 5.1 低 20%:輸入從 10 美元到 8 美元,輸出從 50 美元到 40 美元。
輸出速度比 5.1 快 30%。fast mode 出詞快 2.5 倍,價格翻倍;能開的地方是 Claude Code、Claude Platform、Google Cloud 上的 Claude 模型、Microsoft Foundry,Mythos 的 fast mode 只給驗證計劃的成員。批次介面不能和 fast mode 疊用。
可調的只有 effort:Low、Medium、High、Xhigh、Max。預設值分兩套,Claude API 預設 high,Claude 應用和 Claude Code 預設 medium,同一個提示在兩邊跑出來的深度不同。
FrontierCode 2.0 上的對照:High 檔和 Opus 5.5 的 Max 檔差 0.2 個點,每任務成本約為一半;Xhigh 檔是 Anthropic 測過的已發佈模型裡的最高分;圖上 Max 檔的點落在 Xhigh 下方,加檔不等於加分。
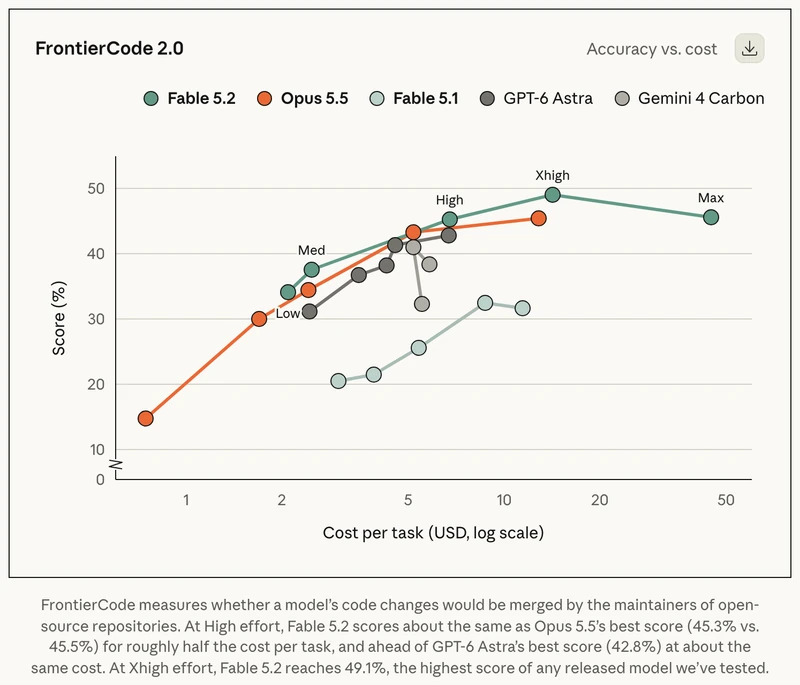
FrontierCode 2.0 測的是模型改的程式碼,開源項目維護者願不願意合進去。Fable 5.2 是 49.1%,比 5.1 高 16.7 個百分點,比 Opus 5.5 高 3.6 個點,比 Gemini 4 Carbon 高 8 個點。
FrontierSWE v2 69.9%,比 5.1 高 13.6 個點,比 Opus 5.5 高 7.6 個點;Terminal-Bench-Science 0.1 74.6%,比 5.1 高 22 個點,比 Opus 5.5 高 15.9 個點,Mythos 5.2 在同一項是 75.3%。
Anthropic 自己程式碼庫裡合入的改動,超過 90% 由 Claude 寫。一個 agent 團隊把一個生產服務從 Python 遷到 Rust,啓動快約 26 倍。
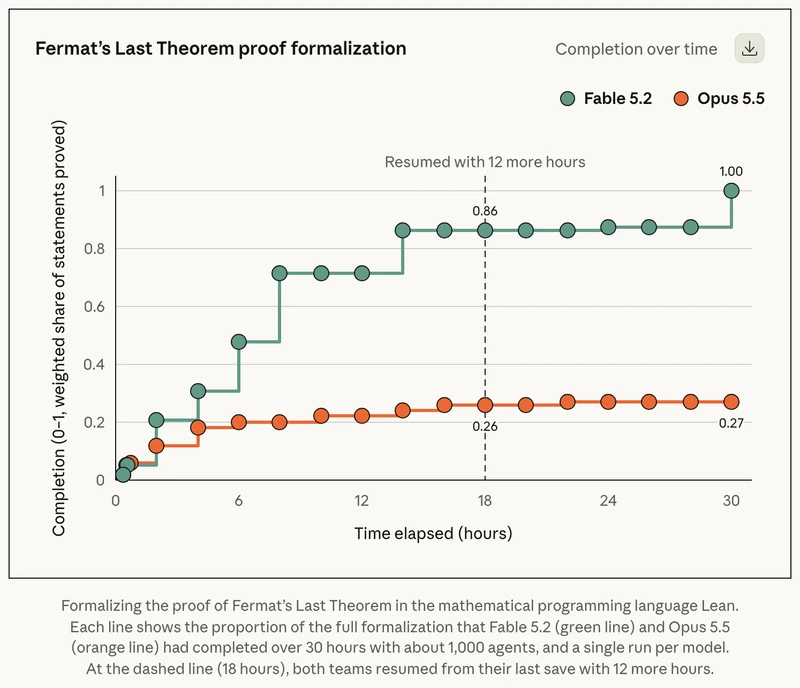
起點是空資料夾,任務是一個操作系統原型。模型調度 1000 多個子智慧體,連續跑八天,寫程式碼、測、審,產出的系統能在筆記本上啓動,自帶內核、磁盤鍵盤網路驅動、永久檔案儲存、視窗、登入介面、安裝器,還有內置的 Claude 功能。
iGent 的測試裡,它一次會話做出帶 3500 多個機器驗證證明的 hypervisor。Uber 讓它跑 10 到 12 小時的安全審計,派出約 170 個 reviewer 智慧體,交回報告、修復 PR 和政策建議。Jump Trading 的內部研究自動化測試裡,Fable 5.2 的誤差比第二名低 10%。
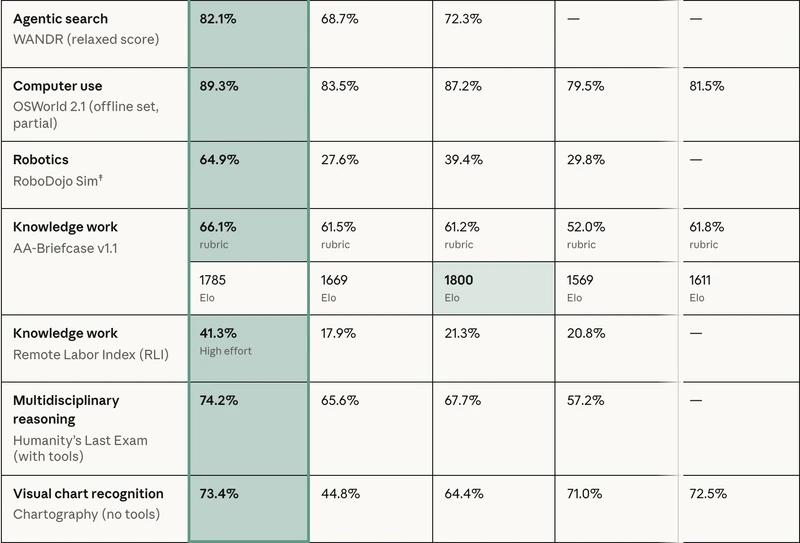
Chartography 測圖表理解,Fable 5.2 是 73.4%,比 5.1 高 28.6 個點,比 Opus 5.5 高 9 個點。
OSWorld 2.1 測電腦操作,89.3%,比 Opus 5.5 高 2.1 個點,比 Gemini 4 Carbon 高 7.8 個點。RoboDojo Sim 測雙臂機器人控制,64.9%,比 Opus 5.5 高 25.5 個點,比 GPT-6 Astra 高 35.1 個點。
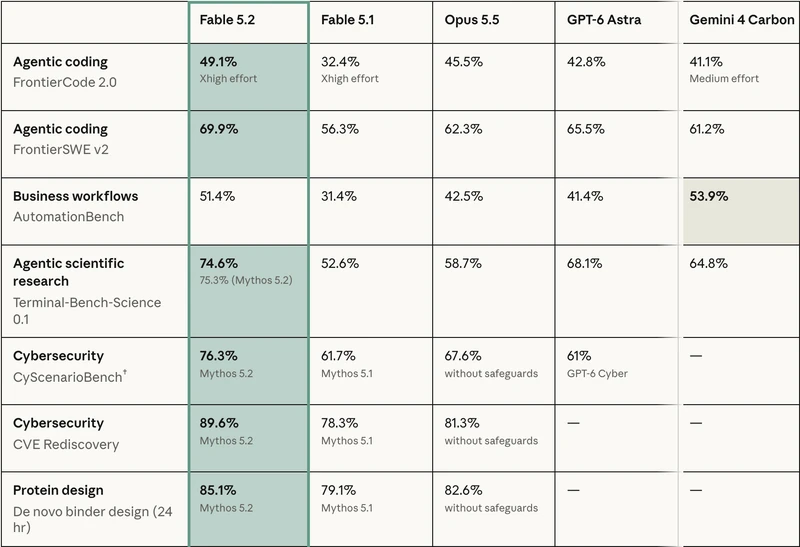
四家的數字來自官方同一張表,按能力分組列 12 項。
| 項目 | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | 45.5% | 42.8% |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% |
| AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% |
| WANDR | 82.1% | 68.7% | 72.3% | — |
| OSWorld 2.1 | 89.3% | 83.5% | 87.2% | 79.5% |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | 29.8% |
| AA-Briefcase v1.1 | 66.1% | 61.5% | 61.2% | 52.0% |
| Elo | 1785 | 1669 | 1800 | 1569 |
| Remote Labor Index | 41.3% | 17.9% | 21.3% | 20.8% |
| Humanity’s Last Exam | 74.2% | 65.6% | 67.7% | 57.2% |
| Chartography | 73.4% | 44.8% | 64.4% | 71.0% |
12 項裡 11 項高於 Opus 5.5,唯一低的是 Elo,1785 對 1800。跟 5.1 比 12 項全部更高,差得最少的是 AA-Briefcase,多 4.6 個百分點。AutomationBench 輸給 Gemini 4 Carbon 的 53.9%,差 2.5 個點。
Gemini 4 Carbon 沒進表:AA-Briefcase 61.8%,Elo 1611。網路安全和蛋白設計三類只有 Mythos 的數字,Fable 被分類器擋住,所以留空。
Fable 5.2 的分類器和 5.1 一樣攔滲透測試、漏洞利用、二進制漏洞分析、研究級生物學任務。誤報率下降:在 claude.ai、Claude Code 和 Cowork 的測試裡,阻斷比 5.1 少約 55%,網路安全類少 60%,生物學少 40%。
Mythos 5.2 的三項:CyScenarioBench 76.3%,Opus 5.5 去掉護欄是 67.6%;CVE Rediscovery 89.6%,2026 年 10 月對 1829 個 CVE 跑的;蛋白設計 De novo binder 24 小時 85.1%。申請走 Cyber Verification Program 和 Life Sciences Verification Program。Claude Enterprise 客戶不進這兩個計劃也能用 Claude Security,底層模型已經包含 Mythos 5.2。
沙盒逃逸專項評估 1800 多個場景,Mythos 5.2 是 3.1%,Opus 5.5 3.3%,Mythos 5.1 21%,Mythos 5 39%。反蒸餾上,蒸餾方拿到的資料少 90% 到 99%。
HelixHarness 由滴滴金融技術團隊開源,跑在 Codex 和 Claude Code 上,要解決的核心問題是團隊工程知識無法沉澱、Agent 每次...
2026-11-01
Claude Duet和Dots、Muse都是同一類東西:帶權限的個人代理,都能讀你授權的應用、在後台幹活、對外動作前要你點頭。真正要取...
2026-10-22
Claude Duet把動作分成兩類:讀取和整理直接做,發訊息、付款、籤檔案先擺出內容再等你點同意。批准環節不是提醒,而是必須經...
2026-10-22
Claude Duet不用重新接一遍:連接器在Claude帳號裡授權,Duet從第一條訊息起就繼承。你在Claude裡接好的郵箱、日曆、文件,它...
2026-10-22
差別在誰先開口:Claude等你打開對話再答,Claude Duet自己巡檢、每天早上先把簡報推給你,任務做完或者需要你點頭時才回來找...
2026-10-22