
VeriSpoof 是墨爾本大學在 2026 年 11 月 3 日提交到 arXiv 的音訊大模型,做語音深度僞造檢測。同一套權重回答四類取證問題,在 Speech-DF-Arena 的合併 EER 是 2.14%,開源權重裡排第一。權重、程式碼、線上 Demo 和評測基準都放在 Hugging Face 與 GitHub 上,許可為 CC BY-NC 4.0,只允許非商業用途。
論文編號 arXiv 2611.04634,作者是 Yang Xiao 和 Ting Dang,兩人都在墨爾本大學。它要解決的不是二分類:一條錄音被當成證據提交時,做取證的人還要知道是哪個系統合成的、和另一段可疑錄音是不是同一個來源、錄製時經過了什麼處理、依據是什麼。
做法是把這幾類問題都變成對同一句答案的打分。模型裡沒有任務專用的輸出頭,每個答案都是模型自己生成的一句話,再用這句話的機率當分數。
公開的東西可以按用途分開找:
介面上把五個問題排成一行標籤,點開每個都能看到示例錄音的選項和分數。
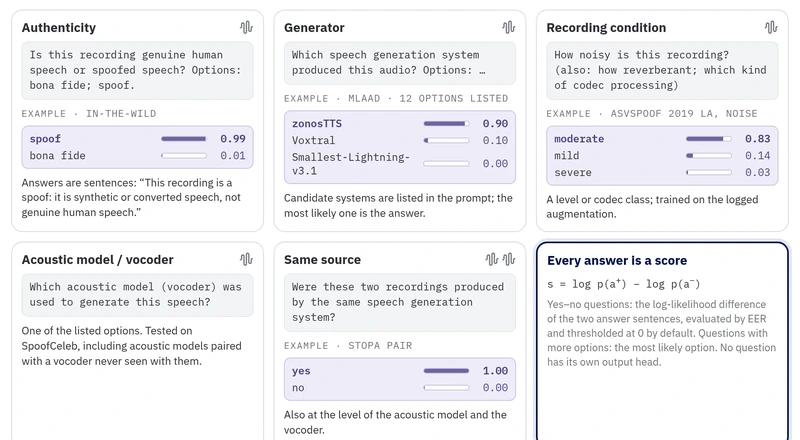
傳統檢測器在最後接一個二分類頭,輸出一個分數。VeriSpoof 把答案本身當輸出,分數從這個答案句的機率算出來:
s = log p(spoof answer) − log p(bona fide answer)這樣做的結果是不存在分數和解釋對不上的環節。榜單上評的那個數,就是使用者讀到的那句話的機率。
兩段現成模型中間加一個從頭訓練的音訊分詞器,三段拼起來是 2.85B 參數,其中只有 29.7M 參與訓練。
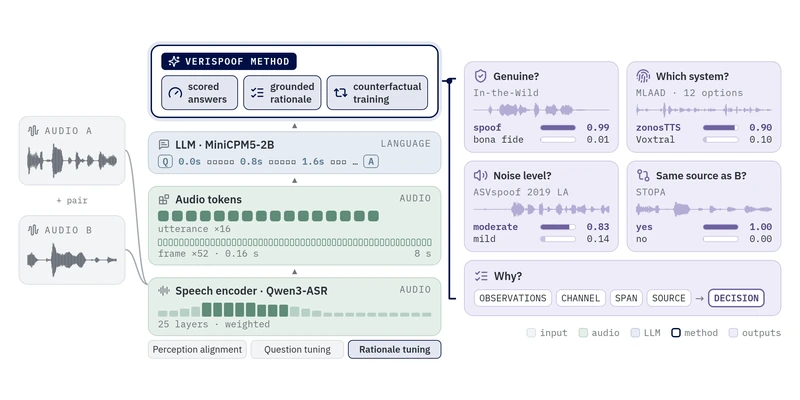
訓練按三個階段推進,每個階段只訓一部分部件:
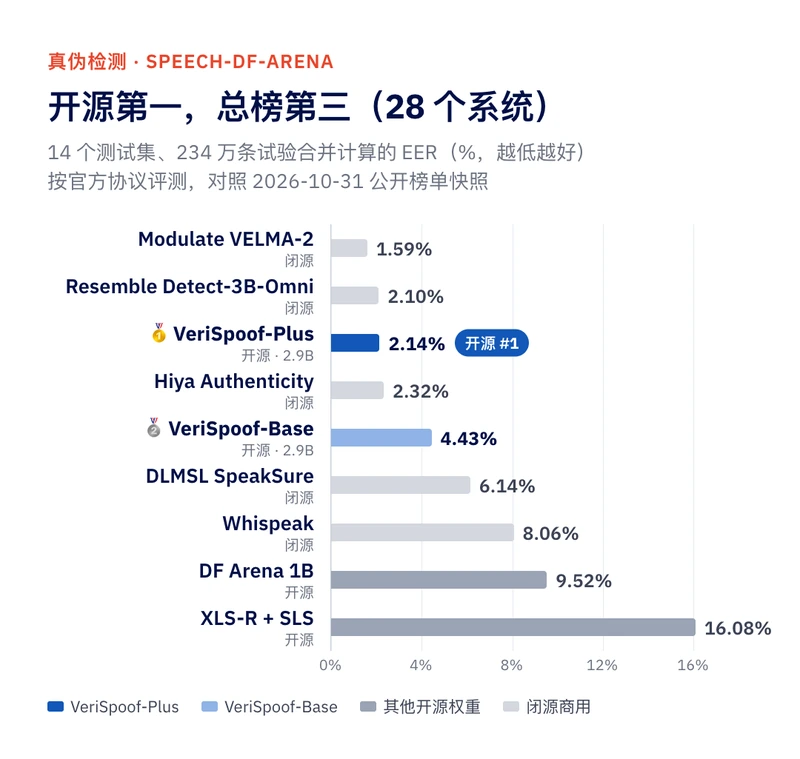
Speech-DF-Arena 官方協議共 14 個測試集、234 萬條試驗,用一個閾值統計全部試驗得到合併 EER。VeriSpoof-Plus 是 2.14%,平均 EER 1.79%;VeriSpoof-Base 是 4.43%。
同源判斷在 MLAAD 上按三種協議測:訓練中見過的生成器、沒見過的生成模型、沒見過的模型架構。對照物是在開源檢測器 DF-Arena-1B 的凍結特徵上專門訓練的配對探針,訓練資料按同一套列表配齊。
| 測試協議 | 配對探針 | Base | Plus |
|---|---|---|---|
| 訓練中見過 | 29.0% | 17.23% | 7.68% |
| 未見生成模型 | 26.5% | 13.80% | 6.17% |
| 未見模型架構 | 24.8% | 20.25% | 15.00% |
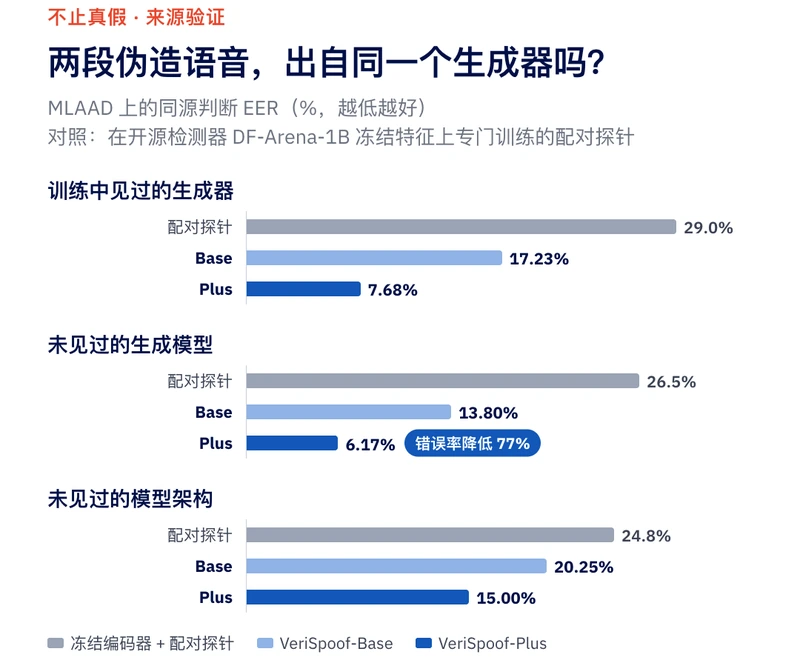
同一套權重還能直接點名生成系統,在 MLAAD 上準確率 96.8%;識別噪聲、混響和編解碼的準確率 81.3%。作為對照,六個通用音訊大模型在同樣的選擇題上,同源判斷落在 48.4% 到 53.3% 之間,二選一的隨機水平是 50%,錄音條件只有 16.4% 到 22.6%,隨機水平是 12.5% 到 20%。這說明音訊理解做得好的模型,不一定能分辨合成痕跡和通道特徵。
推理按固定欄位寫,每一類陳述都有不依賴模型本身的檢查器:
訓練時加了反事實樣本。把推理裡的定位改成“沒有合成片段”,結論要翻轉;只改通道或觀測行,結論必須保持不變。項目頁寫的是,99.5% 的決策能跟隨訓練中沒見過的改法。
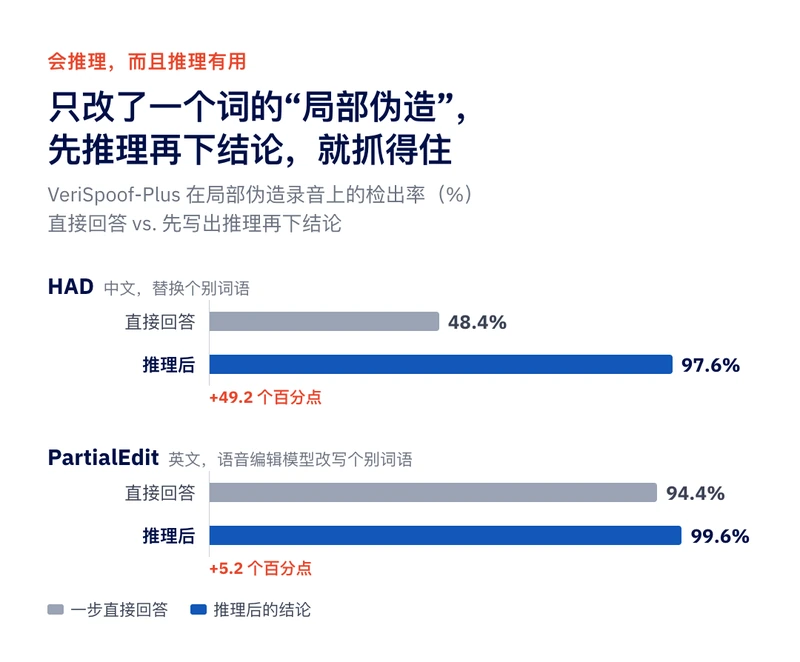
先寫推理再下結論,能抓住一步回答漏掉的區域性僞造。中文集 HAD 上,一步回答的檢出率是 48.4%,推理後到 97.6%;英文 PartialEdit 上,Base 從 78.4% 到 99.6%,Plus 從 94.4% 到 99.6%。逐 token 定位頭在 HAD、PartialEdit、PartialSpoof 上的 F1 分別是 0.91、0.79、0.77。
需要一張 12 GB 顯存以上的 CUDA 顯卡,權重第一次運行時下載。
hf download AustinXiao/VeriSpoof-Plus --include "code/*" --local-dir verispoofpip install ./verispoof/codemodel.detect("sample.wav")model.explain("sample.wav")model.same_source("a.wav", "b.wav", level="generator")model.condition("sample.wav", attr="codec")、model.generator("sample.wav", ["XTTS-v2", "Bark", "VITS"])hf download AustinXiao/VeriSpoof-Plus --include "code/*" --local-dir verispoof
pip install ./verispoof/codefrom verispoof import VeriSpoof
model = VeriSpoof.from_pretrained("AustinXiao/VeriSpoof-Plus")
model.detect("sample.wav") # 標籤 + 分數
r = model.explain("sample.wav") # 推理文字、結論、片段、逐 token 機率
print(r["decision"], r["spans"], r["token_prob"])
model.same_source("a.wav", "b.wav", level="generator") # 也可 acoustic_model / vocoder
model.condition("sample.wav", attr="codec") # 也可 noise / reverb要批次跑可以換 vLLM 後端,官方給的說法是批次時約 46 倍加速。安裝時帶上 [vllm] 擴展,調用改成 VeriSpoofVLLM.from_pretrained,explain 和 compare 都能一次傳多個檔案或配對。
| 版本 | 訓練資料 | 合併 EER | 適合的用法 |
|---|---|---|---|
| Base | 11 個語料,約 38 萬條 | 4.43% | 受控對照實驗 |
| Plus | 23 個語料,約 440 萬條 | 2.14% | 直接使用 |
Base 只用公開語料的官方訓練集,訓練步數 8k、20k、10k,全域性 batch 32,單張 48 GB 顯卡約 14 GPU 小時。技術報告裡的對照研究都基於 Base,復現別人的結論要從它開始。Plus 在同一套配方上多加 12 個語料,僞造部分按 211 個來源均衡採樣、歸併成 82 個架構族,真人部分按 18 個資料集均衡,避免大語料佔多數。
兩個版本的推理開銷一樣,任意採樣率的錄音直接輸入,用 vLLM 批次 64 時一條 A100 上每條約 0.05 秒。
權重、程式碼、Demo、基準都已經是公開狀態,裝上就能跑,不用申請。
語音合成和語音克隆的門檻降到幾秒樣本之後,一個真假分數已經不夠用。VeriSpoof 給出的方向是把取證拆成可以逐條覈對的陳述,分數、來源、位置分開寫,哪一條站不住一眼能看出來。
LibTV 的智慧剪輯是畫布上的一個剪輯節點,在首頁右側點“智慧剪輯”落一個節點,再點節點卡片上的“打開智慧剪輯”進時間軸。一...
2026-11-10
鵝次元是騰訊的 AI 遊戲陪伴客戶端,只有 Windows 版,官網 eciyuan.qq.com 直接下 exe,首測期間聊天、語音、陪玩和生圖都免...
2026-11-10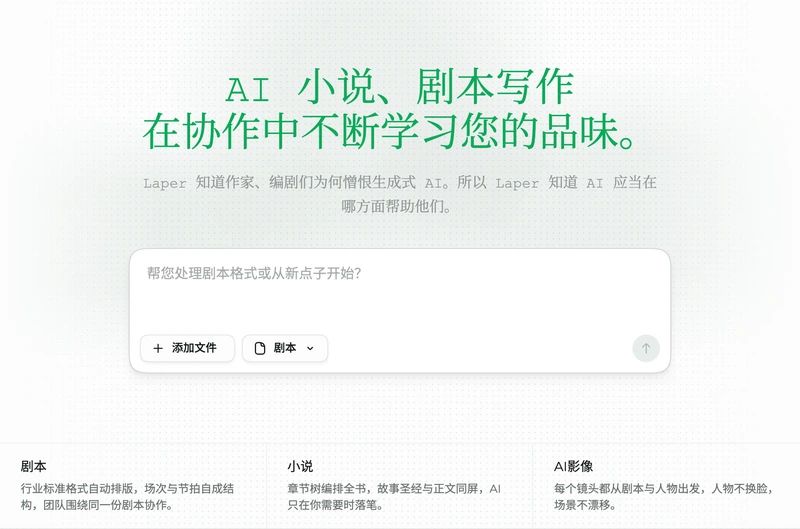
Laper 是 laper.ai 上的 AI 劇本寫作工具,一個帳號能建劇本、電影、小說三種項目,劇本寫正文和場次,電影做分鏡和成片,小...
2026-11-10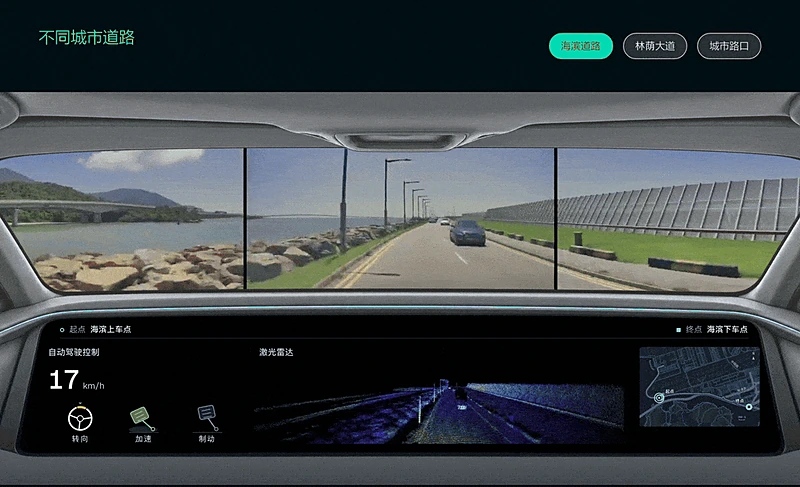
Apollo World 是百度 Apollo 在 2026 年 11 月 3 日深圳百度 AI Day·Apollo 專場上首次披露的世界模型,給 L4 無人車做雲端的...
2026-11-10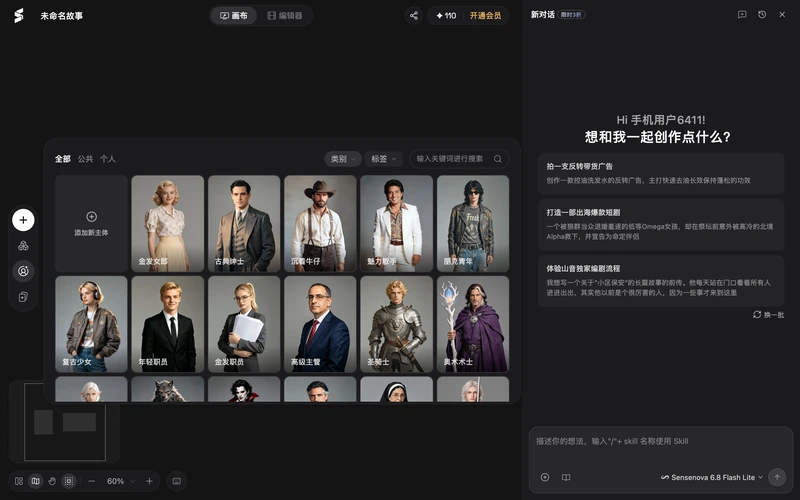
Seko 的內容審覈放在三個位置:主體圖和參考素材上傳、提示詞提交、生成結果返回。主體圖被判違規時,主體庫裡那張卡片會顯示...
2026-11-10