
Apollo World 是百度 Apollo 在 2026 年 11 月 3 日深圳百度 AI Day·Apollo 專場上首次披露的世界模型,給 L4 無人車做雲端的訓練場和考場,目前只用在蘿蔔快跑的全球化測試與驗證裡。它沒有對外的註冊入口,apollo.auto 的新聞區也沒有收錄這一次披露,官方沒說什麼時候開放。能查到的材料只有專場幻燈片、幾段演示畫面,加上蘿蔔快跑的運營資料。
百度給的定位是面向物理 AI 的智慧體驅動全模態世界模型。它不生成一段道路影片給人看,而是搭一座能持續運行的虛擬城市:車輛、行人和騎行者各自有行為邏輯,相機和鐳射雷達的資料同步生成,無人車在裡面可以從接單、前往上車點一直跑到載客和送達。
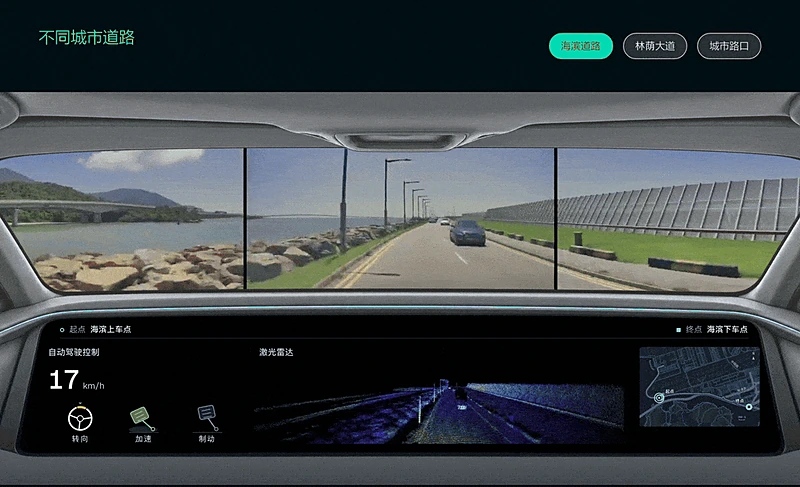
這次披露之前,百度在世界模型方向沒有公開產品。專場上的說法是,Apollo World 給裝在車上的 AI Driver 提供訓練環境,負責出題、改條件和檢驗結果。已經在用的是蘿蔔快跑的全球化測試與驗證,技術棧還能挪到機器人這類場景。
兩套說法要分清。百度智慧駕駛事業群組首席架構師、技術委員會主席王亮講的是判斷標準,世界模型負責人楊澤講的是三項能力,都是同一場專場上給出的。
百度把世界模型的考覈拆成兩層:兩條決定算不算世界模型,三條決定能不能拿來訓 L4。
| 指標 | 官方定義 | 演示裡的對應 |
|---|---|---|
| 因果性(門檻) | 時間單向,由當前狀態推下一刻,不拼畫面反推過去 | 不能先看結局再倒推畫面 |
| 互動性(門檻) | 支援動作條件生成,動作注入後世界狀態隨之改變 | 自車超車,右側車讓行退回 |
| 物理準確性(進階) | 符合光學成像與車輛力學規律 | 雨天剎車距離比干地長 |
| 永續性(進階) | 長時間運行後物體與細節不漂移 | 連跑十分鐘,畫面不崩 |
| 實時性(進階) | 複雜度上升時推理時延不增 | 單幀響應 33 毫秒 |
1/30 秒這個數字來自車的物理條件:一台近兩噸的車以幾十公里時速行駛,開放道路的容錯空間接近零,安全決策週期要壓在這個節拍內,世界模型的推演速度得跟上。
傳統模擬裡,其他車和行人要麼按腳本軌跡走,要麼直接回放實車日誌。主車臨時決定提前變道,錄像裡的旁車不配合,還照原路線開,測試結果就失真。Apollo World 把場景裡每一輛車、騎手和行人都做成有獨立感知與決策的智慧體,主車減速、變道、讓行會觸發各自的反應。
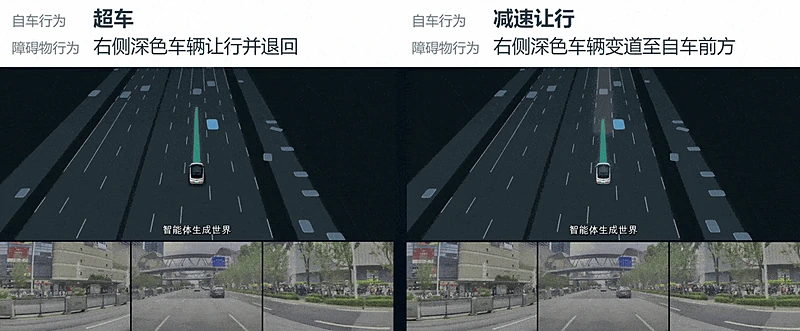
測試人員還能在系統裡調高車流密度,或者調旁車搶道的激進程度,同一段路能出不同難度的題。
每走一幀,模型要同步渲染多路環視相機加起來超千萬畫素的畫面,還有數十萬級的三維鐳射雷達點雲。這兩路觀測得對齊,天氣一變,畫面和點雲要一起變。
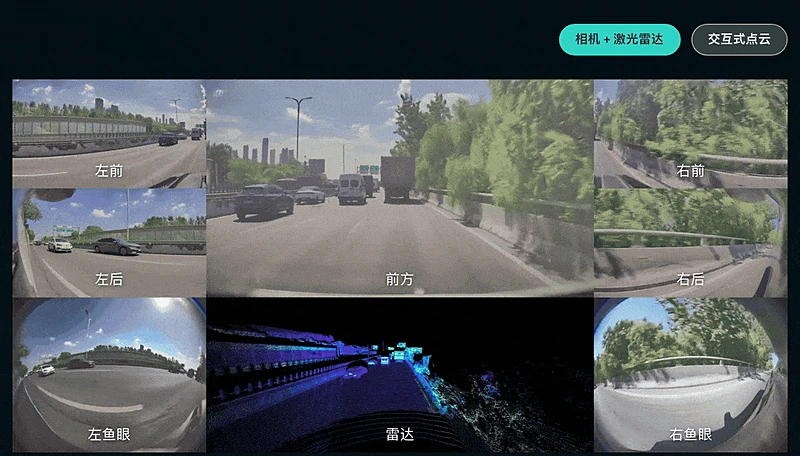
普通影片模型只出 2D 畫面,跑長了車道和街景會走樣。Apollo World 在生成多視角相機畫面的同時生成三維點雲,再引入高精度三維道路結構先驗,同一地點跑幾十分鐘後再經過,街景建築不變形。點雲和畫面跨傳感器一致,車端感知系統不用改造就能直接吃虛擬資料。
同一段城市道路依次切到晴天、暴雨、雪天、夜晚,差別先落在鐳射雷達點雲上。
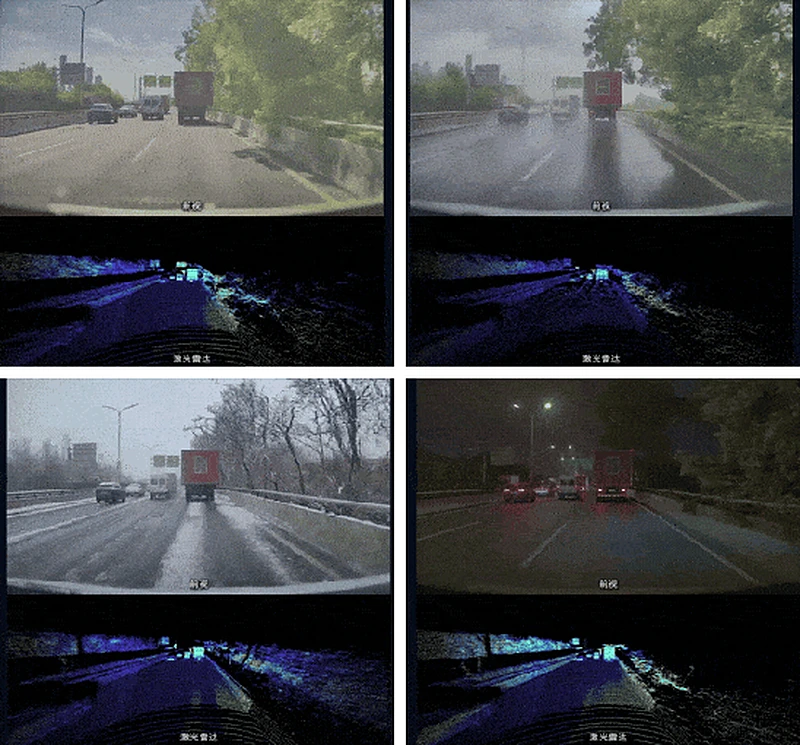
工程師沒有在程式碼裡寫光學或自然公式,這些是模型從超 10 億幀真實資料裡學出來的。兩個能看出差別的例子:兩輛車同樣速度同時踩剎車,乾地上的停在前方貨車後,溼滑路面上繼續往前滑一段;真實路測遇到過一次灑水車高壓水柱把錐桶衝到馬路中間,傳統模擬裡錐桶固定不動,Apollo World 能演算水柱把錐桶衝離原位的全過程。
行業裡多數世界模型只模擬幾十秒的單場景,拉長到跨路段連續行駛,車道結構和畫面細節就開始漂移。Apollo World 支援在虛擬城市任意起終點之間連續行駛十分鐘以上。
香港是右舵左行,路窄彎多、環島密集,對實車測試管得嚴。百度用高精地圖加前期採集的一部分道路資料,在雲端搭了一座虛擬香港,車在裡面把環島讓行和窄路會車反覆跑。
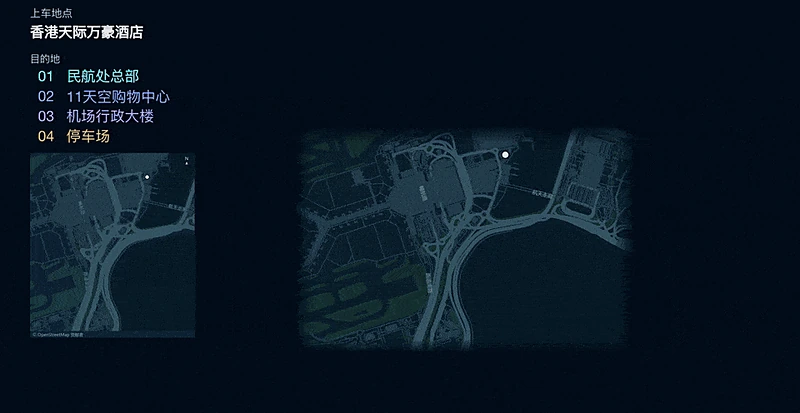
4 輛虛擬無人車從同一個上車點出發,前半程路線相近,過岔路口後分開,各自遇到不同紅綠燈和車流,最後都跑完全程,畫面沒有崩。蘿蔔快跑用幾個月時間拿下香港第一張右舵左行全無人測試牌照,環島讓行和窄路會車都在這座虛擬城市裡先跑過。
效率換算成里程:一天 10 萬公里虛擬路測,按行業測算相當於一輛配安全員的實車連續測約 3 年。自動駕駛每次大版本迭代平均要跑超 70 萬公里帶安全員的實路測試,這部分現在大部分放到雲端跑完,實車只做最後的驗證。蘿蔔快跑目前落地 28 座城市,累計超 2300 萬次出行,自動駕駛里程 3.5 億公里,其中全無人 2.4 億公里。
| 維度 | 傳統模擬 | 影片生成類世界模型 | Apollo World |
|---|---|---|---|
| 周邊參與者 | 按腳本軌跡走 | 以自車為中心建模 | 全員獨立智慧體 |
| 傳感器 | 單相機,按規則生成 | 多為 2D 畫面 | 相機與點雲同步生成 |
| 時長 | 可回放,不可互動 | 幾十秒片段 | 十分鐘以上整單 |
| 物理 | 靠規則引擎設定 | 缺物理回饋 | 擦碰當場判失敗 |
表裡三列模型的差別落在具體動作上。腳本模擬裡,主車臨時變道,旁車不會跟著變;影片生成類模型給的是一段畫面,畫面裡的車不受主車動作影響;Apollo World 把每個參與者當獨立智慧體,車流密度和搶道激進程度還能手動調。
李飛飛的 World Labs 走的是 3D 世界模型這條線,Marble 和 Atlas 把文字、圖像、影片和三維資訊放進統一的空間上下文,解決的是三維空間怎麼建立、怎麼長期儲存。Waymo 的世界模型建在 Google DeepMind 的 Genie 3 上,能生成相機和鐳射雷達資料,用自然語言構造龍捲風、洪水、大象上公路這類場景。
三家並排,差別在路線、輸出、側重和落地場景四處。
| 模型 | 路線 | 輸出 | 側重 | 落地場景 |
|---|---|---|---|---|
| Apollo World | 智慧體驅動 | 相機與點雲 | 城市整單 | Robotaxi |
| Waymo 世界模型 | 通用模型改造 | 相機與點雲 | 長尾事件 | 自動駕駛測試 |
| World Labs Atlas | 三維空間 | 三維場景 | 空間一致 | 機器人與內容 |
三家的分歧只有兩條:交通參與者是不是各自獨立決策,能不能跑完一張完整訂單。兩張表的來源都是各家公開資料,百度一列來自 2026-11-03 專場披露,Waymo 一列來自它對 Genie 3 的公開說明,World Labs 一列來自 2026 年 9 月 Atlas 的發佈資訊,都不是第三方評測。
用不上。百度沒有開放 Apollo World 的註冊入口,也沒有發 API 文件,apollo.auto 的新聞區裡沒有這一次披露,能看到的只有專場幻燈片和演示影片。
能查到的是產業側數字:Grand View Research 預計物理 AI 市場從 2025 年約 816 億美元增到 2033 年約 9604 億美元,2026 到 2033 年複合增長率 36.1%。這是目前能查到這條賽道里帶年份和區間的規模預測。
LibTV 的智慧剪輯是畫布上的一個剪輯節點,在首頁右側點“智慧剪輯”落一個節點,再點節點卡片上的“打開智慧剪輯”進時間軸。一...
2026-11-10
VeriSpoof 是墨爾本大學在 2026 年 11 月 3 日提交到 arXiv 的音訊大模型,做語音深度僞造檢測。同一套權重回答四類取證問題...
2026-11-10
鵝次元是騰訊的 AI 遊戲陪伴客戶端,只有 Windows 版,官網 eciyuan.qq.com 直接下 exe,首測期間聊天、語音、陪玩和生圖都免...
2026-11-10
Laper 是 laper.ai 上的 AI 劇本寫作工具,一個帳號能建劇本、電影、小說三種項目,劇本寫正文和場次,電影做分鏡和成片,小...
2026-11-10
Seko 的內容審覈放在三個位置:主體圖和參考素材上傳、提示詞提交、生成結果返回。主體圖被判違規時,主體庫裡那張卡片會顯示...
2026-11-10