
即梦的短剧声音由画面模型在同一次生成里一并输出,不用另外配音。前提是模型栏选2.0 以上档位,并且台词按角色名加冒号再引号的格式写进提示词;选到 1.0 那一档只出无声画面。
即梦的视频模型分两代,2.0 以上的档位在生成画面的同一次任务里把音轨一并输出。模型内部是两条分支,一条出画面帧,一条出音频波形,靠对齐机制把口型压在语音上。流程里没有先出无声片再配音这一步,成片导出时已经带声音,对白、环境音和背景音乐都在这一条音轨里。
1.0 那一档是纯画面模型,输出没有音轨。同一段剧本、同一段提示词,有人出来的片子有对白,有人出来是哑的,差别就在模型档位。
创作设置面板的视频栏里,模型下拉一共六项,出声与否按档位分:
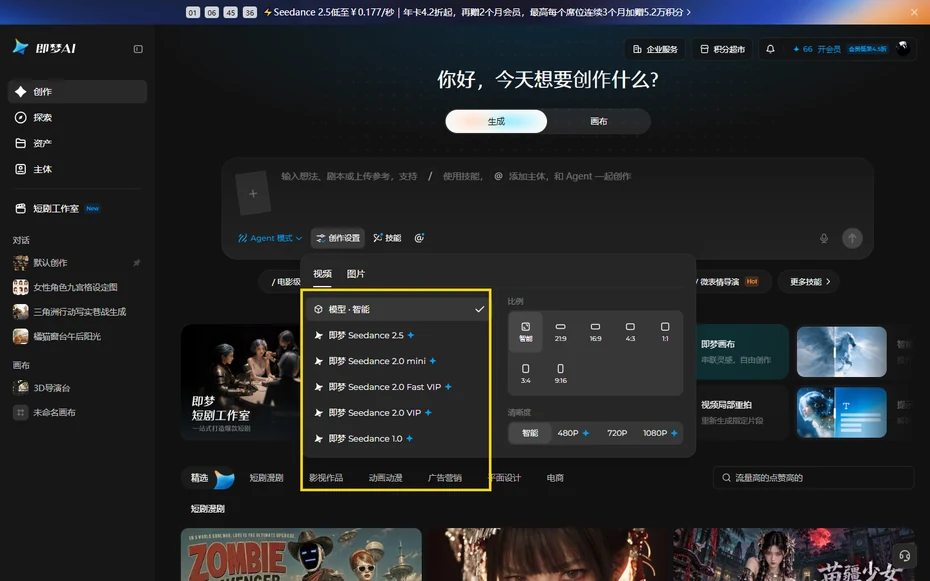
不带 VIP 标记的四项免费账号就能选,带 VIP 的两档要开会员才亮起来。做短剧时想先看构图,用 1.0 省积分可以,但别拿它验收声音,它本来就不出声。
模型不会自己判断哪句话是谁说的,得在提示词里标出来。写法是角色名在前,跟一句动作或表情,冒号后面用引号包住台词原文,多角色一人一行。
1. 先写角色名和这一镜的动作,例如女主低头哽咽
2. 冒号后直接用引号写台词原文,不加他说她说这类转述
3. 第二个人物另起一行,格式与前一行相同
两个人物同框却不标说话人,模型容易把台词分给错的人,或者干脆不开口。台词前后加上语气和语速的描述,念出来的节奏会更贴画面,例如缓慢说、压低声音说。这种写法和即梦对口型功能的用法不是一回事,那条路是拿现成音频去贴画面,这里是让模型自己念。
一个镜头塞一整段对白,后半句的口型就跟不上了。规则是一句话一个镜头,长台词拆成两个镜头接。按即梦提示词指南的口径,10 秒镜头配 20 字台词是上限,超过就得拆。
拆的时候保留动作连贯,前一个镜头说完半句停在表情上,下一个镜头从回应动作接。台词里带停顿的位置也写出来,模型才知道哪里该停。
同一部短剧里,同一个角色跨集保持音色,靠两件事。一是每一集的提示词里重复同一句音色描述,措辞一个字不改,例如低沉偏沙哑的男声、语速偏慢;二是把上一集里这个角色的声音片段当参考素材带上,2.0 档位支持音频参考输入。
角色名也要统一。第一集叫阿哲,第三集改成男主,模型会当成另一个人处理。角色形象和声音绑在同一套描述上,描述一变,两条线一起漂,所以锁角色特征和锁音色要用同一句描述。
写清楚才带。即梦合成的声音分对白、环境音和配乐三部分,但配乐不是自动铺满全片,得在提示词里点明要什么乐器、什么节奏、从哪一镜进、音量压到什么程度。不写的话出来只有对白和现场环境声,配乐要自己后期加,加的时候还要避开人物说话的段落。
能。成片导出后在剪辑软件里把原音轨分离,换成自己录的对白或别的音色。不过原片的口型是按模型自己念的那版台词生成的,换人重配之后发音节奏变了,口型对不上,时间轴要重新调。角色多、台词密的话,换配的工作量比重新生成一条还大。
能,把口音要求直接写进提示词就行,例如四川话、东北话、粤语。即梦的音画同步支持多种方言的口型和发音,标了之后模型按方言的发声习惯合成语音,嘴型也跟着变。不标的话按普通话念,台词里夹着的方言词会念得很别扭,得逐句改回书面语。
写在人物台词之外单独一行,先标明这是旁白,再把要念的整段文字给全。旁白没有对应的人物口型,模型会当画外音处理,画面里不用出现说话的人。旁白和台词混在一行写,模型容易把旁白当成某个角色说的话,还会照着这段话给它配上口型。

即梦是字节跳动推出的AI视频生成工具,最近热度挺高。新用户注册后会获得一定的免费额度,差不多能生成几十秒的视频,超出之...
2026-10-09
即梦数字人是即梦AI里的出镜口播功能,官网入口是jimeng.jianying.com,在创作页选数字人就能让虚拟人替你出镜念文案。我做短...
2026-10-10
即梦数字人入口在创作页的文本生视频里,官网jimeng.jianying.com,登录后选”数字人”模式就能用。我刚用的时候也...
2026-10-10
即梦生成数字人要先在数字人广场选形象或创建专属分身,官网jimeng.jianying.com,贴文案就能让数字人出镜念稿。我从注册分身...
2026-10-10
即梦数字人功能在”文本生视频”里打开,官网jimeng.jianying.com,登录后点创作、选文本生视频、输入文案就能看到...
2026-10-10