
記憶張量推出,Flash和Nano兩檔開源。MemT 1.0 是記憶張量做的記憶原生基座模型,權重已經公開,分 Flash 與 Nano 兩個版本;它把歷史資訊編碼成模型內部的記憶狀態,推理時直接讀寫,不再依賴外掛檢索把原文塞進上下文。
開發方是記憶張量,主營方向就是記憶機制,這個模型是他們的基座產品,不算應用層工具。權重在程式碼倉庫和模型倉庫兩處皆可拿到,技術報告也一併公開,論文裡有訓練細節和基準結果,判斷能力時看報告比看介紹頁靠譜。
這類基座模型沒有客戶端,也沒有網頁版入口,本地部署是主要用法,另一種是接進自己的 Agent 框架。想看效果先跑官方示例腳本,比直接接業務系統省事。
兩檔按“總參數加啟用參數”的方式標註,Flash 是兩百多億啟用、近三百億總參數那一檔,Nano 是三十多億總參數、三億啟用那一檔。前者面向服務端,後者能進端側和輕量環境,選型時按硬體和延遲要求分。
| 版本 | 總參數 | 啟用參數 | 適合的部署 |
|---|---|---|---|
| MemT 1.0 Flash | 288B | 17B | 服務端、多使用者併發 |
| MemT 1.0 Nano | 36B | 3B | 端側、單使用者長會話 |
表裡的啟用參數決定單次推理開銷,總參數決定記憶容量上限。Nano 那一檔的參數規模看起來像小模型,它的賣點不在通用能力,而在記憶狀態不隨歷史增長而膨脹,長會話場景才有意義。
做法是在選定的 Transformer 模塊裡並聯插入記憶模塊,一條路走原注意力處理當前輸入,另一條路查詢記憶狀態讀取歷史,兩路結果融合後繼續往後算。記憶由動態區域性記憶和超記憶兩層組成,前者存壓縮後的歷史,後者提供投影與門控參數。
更新靠門控機制逐 token 完成,每輪互動結束後把新資訊寫進記憶矩陣,擦除、寫入、遺忘、輸出四個門控分別控制舊關聯的調整、新資訊的注入、保留強度和記憶對回答的影響。訓練分兩段,先用大規模資料做持續預訓練建立依賴記憶的語言建模能力,再用後訓練讓學生只憑記憶狀態學教師的行為。
差別在記憶存在哪。接入方式上,第三方平台按介面地址和協議填,和普通模型服務的接法一致。外部記憶庫把歷史存成明文,查詢時檢索相關片段再注入上下文,工程實現靈活但成本隨歷史線性增長;MemT 1.0 把歷史壓進參數化的記憶狀態,狀態大小固定,長曆史下的儲存和推理開銷均不膨脹。
| 對比項 | 參數化記憶 | 文字記憶庫 |
|---|---|---|
| 儲存形態 | 模型內部狀態 | 外部明文 |
| 查詢方式 | 前向計算直接讀 | 檢索後注入上下文 |
| 是否要原文 | 不用 | 要 |
| 細節保真 | 有壓縮損失 | 原文完整 |
表裡第四行是它的短板,重要細節的保真度不如明文檢索,長曆史下差距更明顯。所以這兩種方案不是替代關係,官方也把它們定位成互補:明文記憶負責精確回溯,參數化記憶負責長期經驗,兩者拼起來才是完整鏈路。
適合的場景共同點是“跨會話、要記住、又不方便每次喂原文”。長期陪伴型助手記住使用者偏好,客服 Agent 記住客戶歷史溝通,程式設計 Agent 複用失敗模式和驗證流程,屬於這一類。長週期項目裡上下文視窗耗盡被迫重開,也是它要解決的問題。
邊界同樣清楚:要精確引用合同條款、法規原文、逐字對話記錄的場景,仍然得有明文儲存兜底;記憶狀態序列化後可以儲存恢復,但跨設備遷移要按自己的儲存方案設計。另外記憶資產歸部署方,這一點對企業有吸引力,前提是你真的把狀態管起來。
權重公開,下載不收費,成本在部署和算力上。Flash 那一檔要服務端顯卡,Nano 可以進端側設備,兩者對硬體的要求差一個量級。許可證的具體條款看倉庫頁面,商用、再分發、署名的要求各不相同,用在對外產品裡前先讀一遍。
不能完全替代。RAG 靠明文檢索保證細節準確,適合需要引用原文的場景;MemT 1.0 把歷史壓成參數化狀態,適合長期經驗和偏好沉澱。兩者重疊在“記住使用者”這件事上,差異在“逐字複述”。要精確回溯的場合仍然要留檢索這條路。
能,按序列化的方式做。記憶狀態可以儲存到外部儲存,下次會話恢復後延續此前積累的經驗;跨設備時把狀態檔案搬過去,再在新環境載入即可。要注意的是狀態與模型版本綁定,換了權重版本後舊狀態不一定能直接用,遷移前先確認相容性。
差在記憶是不是模型的一部分。普通大模型靠上下文視窗帶歷史,視窗滿了就丟;MemT 1.0 把歷史寫進內部狀態,視窗之外還能調用。通用能力上兩者接近,官方口徑是在無關記憶噪聲下指令遵循、程式碼、長文字理解基本持平,差別主要體現在長會話場景。
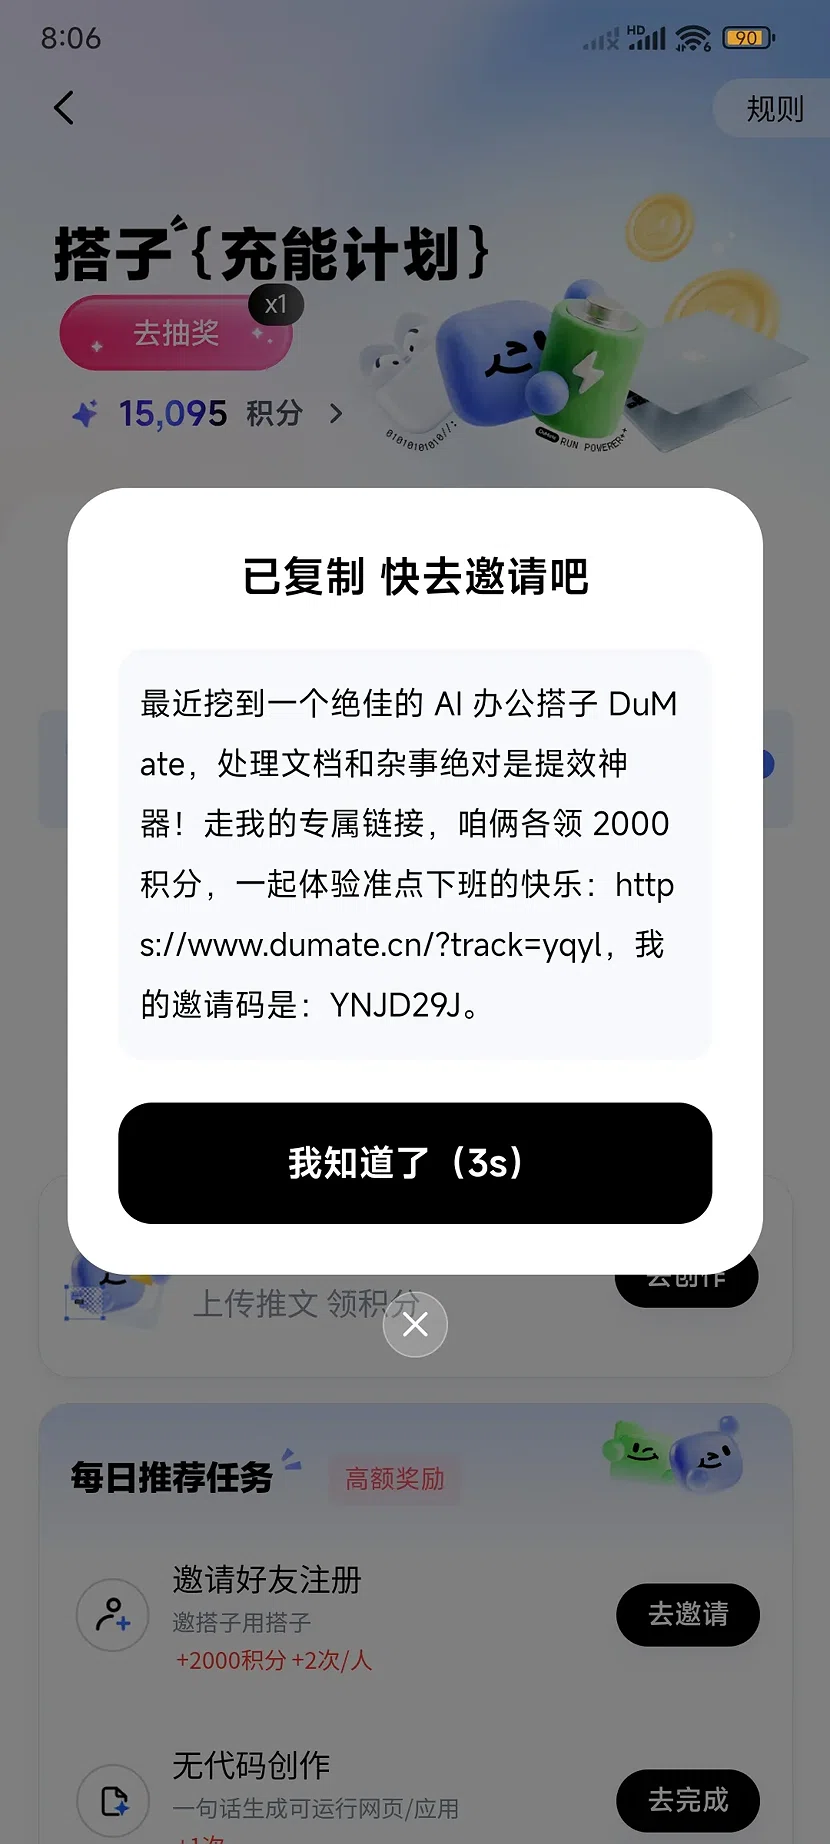
百度搭子邀請碼,是AMPC59C。點選“三條槓-禮物-充能計劃”,在兌換好友邀請碼去填寫。在每日任務裡的邀請好友,點選“去邀請”,...
2026-10-25
即夢的 5.0 是圖片模型,它本身不出影片,影片走另一條檔位線。想用 5.0 的畫面感做片子,正確路徑是先出圖、再把圖交給影片...
2026-10-25
即夢的參考圖上限跟著模型檔位走,常見是十張到二十張,換了檔位跟著變。同一張畫布上換個模型,參考圖能加的數量就不一樣,...
2026-10-25
即夢的智慧畫布匯出的是合成後的成品,按畫布尺寸出圖,格式按用途挑。畫布里除了拼圖,擴圖與消除產生的圖層也要一起合成,...
2026-10-25
即夢的智慧畫布有兩個入口,首頁側欄直接開新畫布,生成頁把成品拖進去。前者從零開始搭版面,後者拿已經出好的圖繼續改,兩...
2026-10-25