
自動字幕在官方能力清單裡,和另外三項並列。真正省時間的不是識別本身,是改錯字的方式:在對話裡說哪一句錯了,它改文字,時間線不動。識別要靠模型,錯字集中在專業詞和人名;改字要靠對話,比在時間線上翻片段快得多。
CapCut官方給外掛列的四項能力裡,自動字幕是其中一項,另外三項是搜範本、剪影片、生成圖和影片。這條寫得很明確,不需要猜。
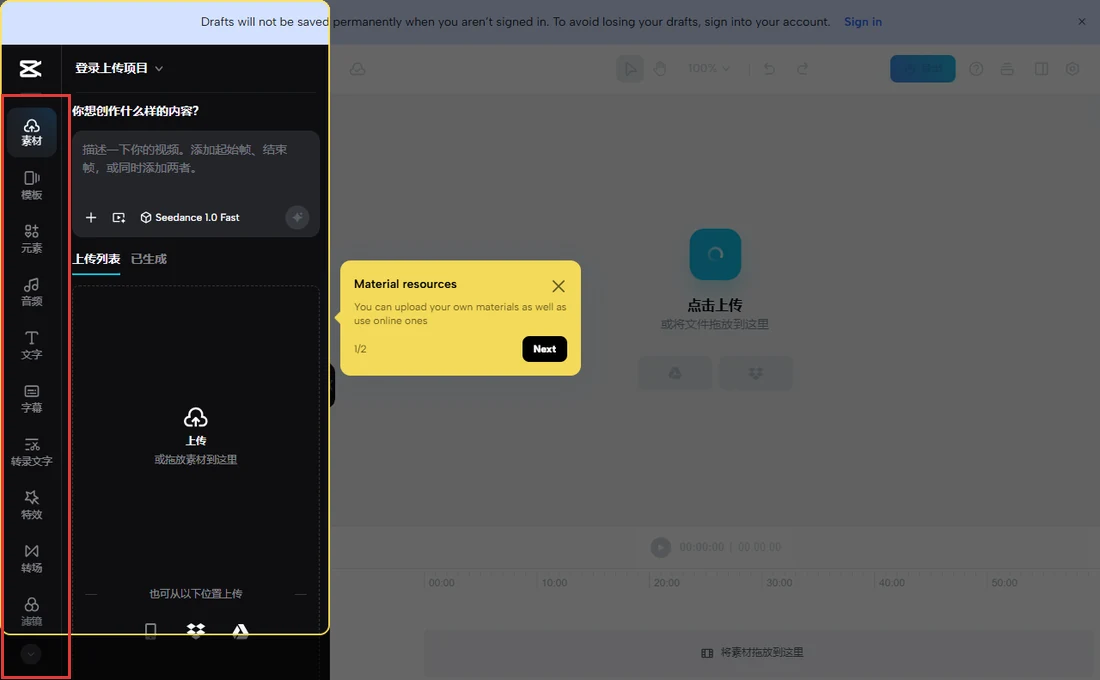
編輯器裡對應的入口有兩個:字幕和轉錄文字。字幕面板處理的是上屏文字,轉錄文字面板處理的是把語音轉成文稿,兩者分工不同,前者管顯示,後者管內容。
這兩個面板的存在說明一件事:字幕在這個體系裡是獨立圖層,不是燒在畫面上的。是不是獨立圖層,決定了後面能不能改、改起來有多貴。
這是新版和舊版最大的差別。舊版是生成一條字幕軌讓你自己去時間線上拖,新版是在對話裡說改哪一句,它改文字、對時長、重排位置,時間線本身不動。
這個差別在返工的時候最明顯。舊方式改一個字,要找到那個片段、進編輯態、改完再對齊;新方式是把錯的那句念出來,剩下的它處理。
不動時間線還有個隱含好處:畫面和音訊不受影響。改字幕不會觸發重新編碼,畫質不會因為改字而掉一代。
自動字幕處理的是說話的轉寫,標題字幕處理的是畫面上那幾個大字。這兩者不該合成一條軌,因為要求完全不同:前者要跟著語音走,後者要跟畫面節奏走。
標題字幕放在文字層,用大字、粗體、短句。一句不超過九個字,豎屏下最多兩行。它出現的時機通常是開頭抓人、中間強調、結尾落版三處,不是全程都在。
合成一條軌的後果是改一個標題會牽動整段字幕的對齊。分開做,改標題只動文字層,自動字幕完全不受影響。
第一是專業詞和人名。模型見過的通用詞多,生造詞和小衆品牌名識別錯是常態,這類錯字只能人工校一遍,靠調參數解決不了。
第二是背景音。音樂壓過人聲的時候,識別會把歌詞混進字幕裡,出現一堆莫名其妙的句子。素材本身錄音環境差的,先做人聲增強再識別,準確率會明顯不同。
第三是多人重疊說話。兩個人搶話的部分,識別容易把兩句併成一句。這種片段建議單獨拎出來手動處理,別指望一次性過。
字號、字重、描邊、位置、行數,這五項定下來就是一個樣式。定好之後整片複用,不要一句一句調,那樣永遠調不齊。
豎屏下推薦的做法是白字加深色描邊,字號定在中等偏大,位置壓在離底邊五分之一以上的地方。描邊的作用是抗背景干擾,淺色畫面裡沒描邊的白字會看不見。
要手動熟悉字幕這一套流程,可以照即夢影片匯入剪映做成片的步驟走一遍,裡面講到了字幕層的處理順序;多工具一起用的,這套串聯順序也有對應的做法。
支援。這項能力在中文場景裡是主力功能,識別中文語音沒有問題,標點也會自動加。需要留意的是中英混說的片段,外語片段容易被按中文音譯出來,遇到這類素材,單獨把那幾句摘出來手改,比整段重識別快。中英混說的片段,單獨摘出來改更快,這類素材佔比不高。
不會。字幕是獨立圖層,改文字只動這一層,畫面和音訊完全不受影響,也不會觸發重新編碼。這也是判斷字幕做得好不好的標準之一:改一個字要重錄畫質的,說明字幕被燒進畫面了,那種做法在改稿階段代價很高。想確認有沒有燒進去,雙擊字幕看能不能選中。
技術上能合成一條軌,實際不建議。兩者跟著的節奏不一樣:自動字幕跟語音,標題跟畫面情緒,合在一起之後改一處動全身。分開兩層,改標題隻影響文字層,改對白隻影響字幕層,各自獨立,出錯也容易回退。兩層各自的位置和出現時機也不同,改的時候分別定位,別一起選。
先分清錯在哪一類。專業詞和人名的錯,只能人工校,沒有別的辦法;背景音混進來的錯,先做人聲增強再重識別;多人搶話的錯,把那幾段單獨切出來處理。三類混在一起改,會覺得怎麼改都改不完,分開處理效率差好幾倍。這一步分開做,能省下大半返工時間,順序別亂。
1. CapCut 官方 CapCut×Codex 頁面:https://www.capcut.com/zh-tw/tools/capcut-x-codex
停頓和重複是口播裡最佔時長的兩樣,也是最容易被刪錯的兩樣。停一秒是氣口,停三秒是冷場;同一句話說兩遍,第一遍可能是鋪...
2026-10-28
多語言字幕不是一次翻譯,是兩次動作:先把中文轉寫成稿,再把稿子譯成目標語言,最後校一遍術語。轉寫必須先準,轉錯的字譯...
2026-10-28
橫屏改豎屏不是把畫面裁窄,是把鏡頭裝進另一個框。橫屏能看到左右,豎屏只能看到中間那一豎條,被裁掉的部分往往是資訊所在...
2026-10-28
十二秒豎屏是官方演示出現過的場景,背後有一套硬約束:總時長固定、畫幅固定、素材數量固定。都限死的時候,剪法就從挑好看...
2026-10-28
這一環要分清兩個來源:CapCut的線上素材庫和你的本地檔案。前者有專門的檢索工具,參數是類型、提示詞、返回條數;後者靠代...
2026-10-27