
能,但靠的不是一個“鎖定角色”開關。PixTV 首頁把 AI 分鏡(AI Storyboard)單獨列成一項能力,真正的做法是讓同一張定妝圖在每個鏡頭裡被重複引用:臉不變,是因為參考圖沒變。首頁公開的內容只有六個模型和八項創作能力,沒有角色一致性的專用按鈕,也沒有公開額度數字。
還沒帳號?立即註冊。先拿免費額度跑一遍分鏡,比自己摸索一致性參數快。
角色漂移大多不是模型的問題,是每一鏡都重新描述了一遍人物。文字描述每次都有細微差別,模型就每次畫一張新臉。PixTV 的首頁把“AI 分鏡”和“提示詞反推”放在同一組能力裡,這個組合的用法就是先定一張臉,再讓所有鏡頭圍著它轉。
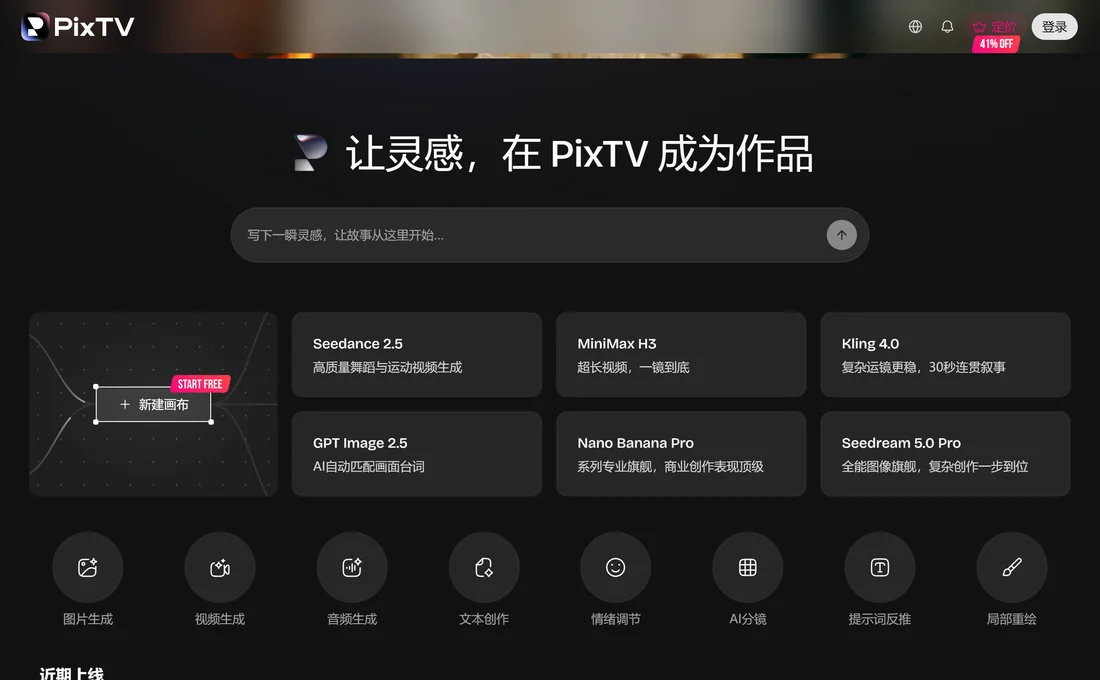
PixTV 首頁實拍:圖片生成、影片生成、音訊生成、文字創作、情緒調整、AI 分鏡、提示詞反推、區域性重繪八項
1. 先用圖片生成做一張正面定妝圖,五官、髮型、服裝全部確定下來。
2. 把這張圖存成角色參考圖,後面每個鏡頭都以它為起點。
3. 描述裡只寫動作、機位、光線,不再重複長相。
這三步做完,一致性就不再靠運氣。反過來,如果每一鏡都從純文字開始,臉一定會變。
首頁給了六個模型和各自的一句話定位,直接按用途挑就行,不用猜。Seedance 2.5 主打舞蹈與運動類影片,MiniMax H3 主打單鏡頭超長影片,Kling 4.0 主打複雜運鏡,30 秒一鏡到底。
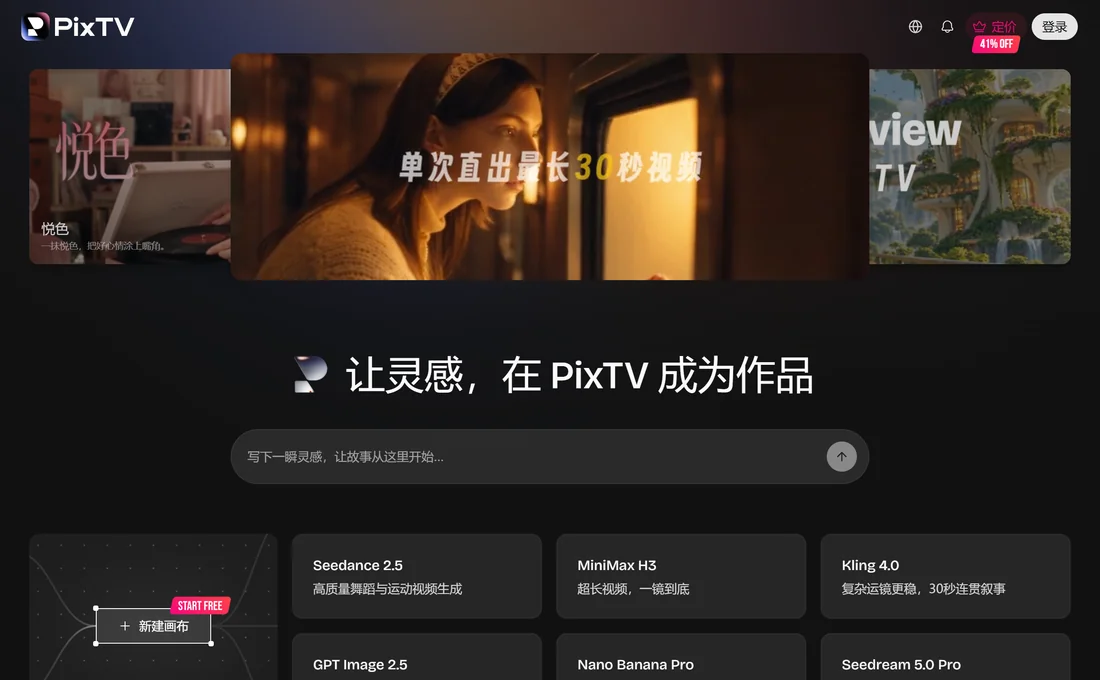
PixTV 首頁實拍:影片側三個模型各有分工,圖片側三個模型按商業精修與複雜創作分工
1. 人物動作大、要跳舞或跑動的,選 Seedance 2.5。
2. 需要一條鏡頭拍到底不切、時長偏長的,選 MiniMax H3。
3. 要複雜運鏡、繞人轉圈的,選 Kling 4.0,它寫明支援 30 秒無縫敘事。
圖片側三個模型的分工是:GPT Image 2.5 會自動匹配畫面與對白,Nano Banana Pro 面向商業創意的高階需求,Seedream 5.0 Pro 主打一步完成複雜創作。定妝圖建議用 Nano Banana Pro 或 Seedream 5.0 Pro 出,臉越穩定,後面越省事。
分鏡做多了總會有一兩鏡臉歪。這時候別整張重生成,用 Inpainting 只改臉部區域,其餘畫素不動,一致性反而更容易保住。
1. 在出問題的那一幀上框住臉和脖子,範圍別擴到肩膀。
2. 提示詞只寫五官,不要帶場景和機位描述。
3. 重繪兩三次還不像,回退到定妝圖重新生成這一鏡。
還有一項容易被忽略的能力是提示詞反推。看到一張想要的臉,先用它把提示詞反推出來,再拿這段提示詞去做定妝圖,比手寫描述準得多。
官網首頁沒有公開任何價格或額度數字,註冊後才會顯示。看到“免費”“無限”這類宣傳時,以登入後的帳戶頁為準。
1. 註冊後先看帳戶頁的額度單位,是積分還是次數。
2. 用它跑一條 5 秒短片,記下扣了多少。
3. 按這個單價倒推自己能做幾個鏡頭,再決定要不要付費。
如果你的項目是連續劇式的人物短片,一致性比單條畫質更重要,先把定妝圖和分鏡範本跑通,再談額度。
會。不同模型對同一張參考圖的理解不一致,同一個人物在 Seedance 2.5 和 Kling 4.0 裡會呈現兩種畫風。所以一部片子從定妝圖到分鏡儘量鎖定同一個模型,中途換模型等於重新建立角色。確實需要混用,就在切換後用區域性重繪把臉修回去,別指望它自動對齊,換模型前先做一次小樣對比,成本最低。
能做,但只能靠提示詞固定,穩定性差一截。做法是把長相描述寫成一段固定範本,每個鏡頭原樣複製,只改動作和機位,然後用提示詞反推檢查模型是否真的照做了。首頁把提示詞反推列為獨立能力,就是給這種場景用的。真要做系列內容,還是先花一次成本把定妝圖做出來。
官網對 Kling 4.0 的原話是 30 秒無縫敘事,MiniMax H3 的原話是單鏡頭超長影片,沒有給具體秒數。所以能確認的上限是 30 秒這一檔,更長的只能靠多段拼接,別指望一條過。拼接時注意讓上一段的最後一幀作為下一段的首幀,臉和光線才接得上,否則兩段之間會跳,觀衆一眼能看出來。
首頁把音訊生成列為一能力,也對 GPT Image 2.5 寫了“自動匹配畫面與對白”,但沒有說明支援哪些語言。中文對白的實際效果要自己試,建議先用一句短台詞驗證口型和字幕,別一上來就做整段。聲音不穩時先把畫面做完,音訊單獨生成再合成,返工成本更低,也方便事後換配音。
不用。PixTV 走的是 Email 註冊,實測整個註冊流程沒有出現要求填中國手機號的欄位,新帳號完成註冊後系統自動送 10 積分。台...
2026-10-27
PixTV進不去先分兩件事:首頁打不開是訪問層的事,首頁能開但點功能就跳登入是登入層的事。我這邊直連官網返回正常,不登入也...
2026-10-26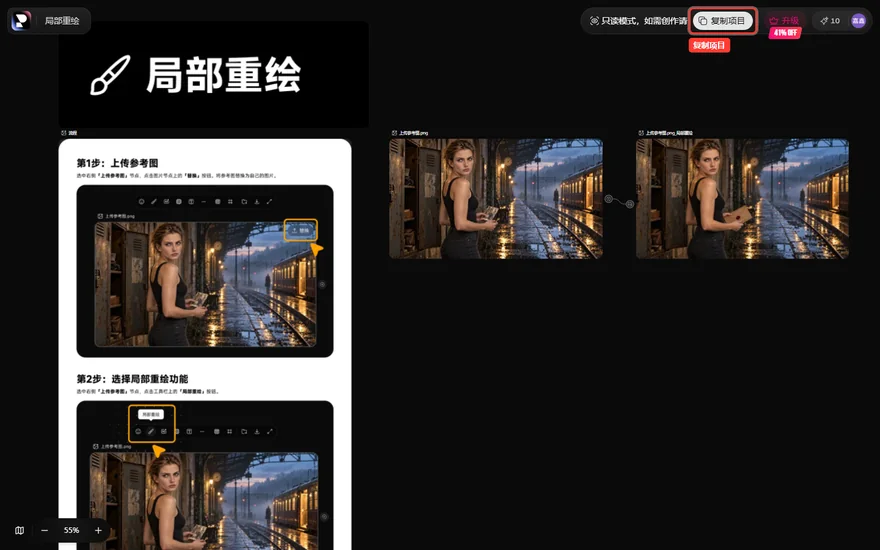
PixTV區域性重繪分兩步走,先把參考圖傳進節點,再點工具欄上的區域性重繪按鈕去塗抹要改的地方。塗到哪改到哪,沒塗的部分原樣保...
2026-10-26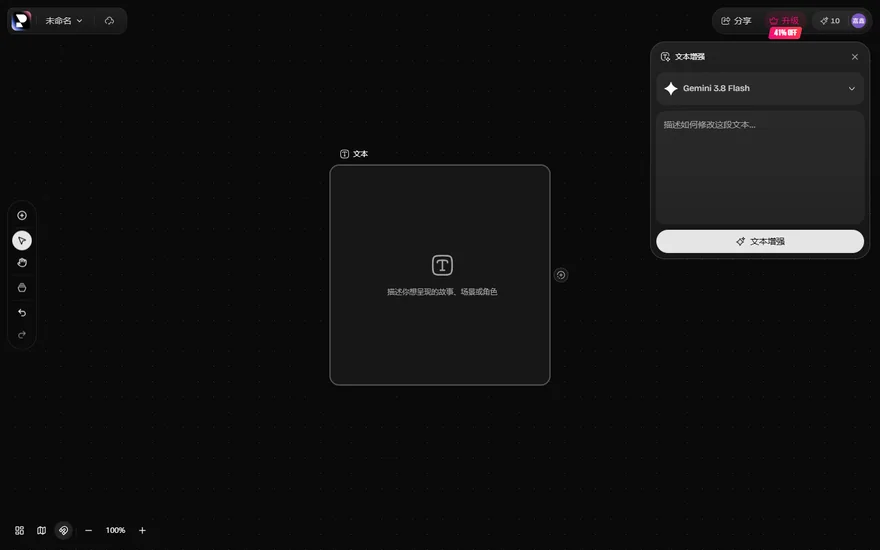
PixTV文字創作在畫布的文字節點裡,右邊面板只有一個模型下拉和一個“文字增強”開關。預設模型是 Gemini 3.8 Flash,點文字增...
2026-10-26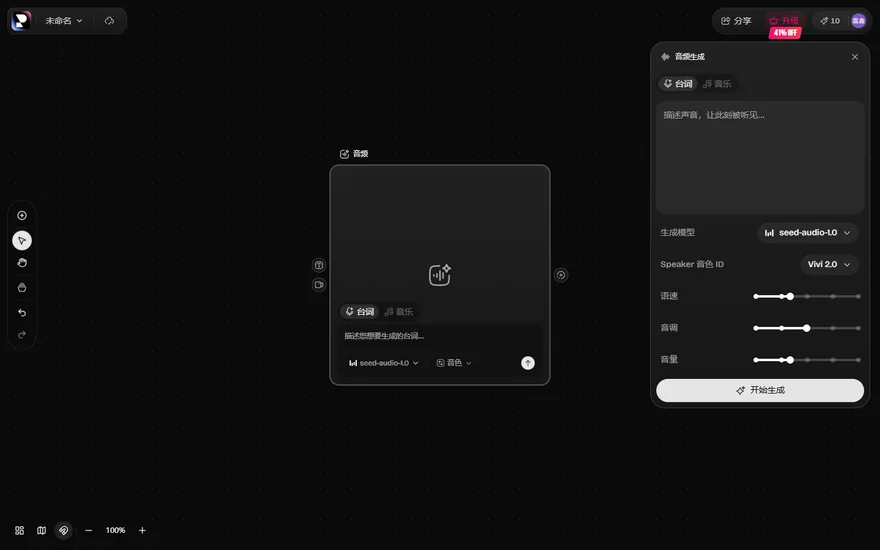
PixTV音訊生成在畫布的音訊節點裡,右邊面板能選模型和音色,語速音調音量三個滑塊調完點開始生成。模型是 seed-audio-1.0,...
2026-10-26